分类: 技术

  • 全方位WordPress添加水印方法汇总

    全方位WordPress添加水印方法汇总

    今天给大家讲讲 WordPress 给图片加水印的插件介绍和方法,给图片添加水印其实没什么技术含量,图片添加水印一方面是为了预防盗图,另一方面提高网站知名度。

    ​

    WordPress上传图片添加水印插件推荐

    如果你每次给图片添加水印麻烦,那么使用插件可以帮你自动添加水印,WordPress平台自动添加水印的插件很多,这里给大家推荐两款用过效果不错的插件。

    插件推荐1:DX-Watermark

    插件推荐1:DX-Watermark

    DX-Watermark 这是一款很古老的图片水印插件了,虽然作者6年没更新了,但是使用一切都正常。支持添加文字水印和图片水印。

    DX-Watermark支持的功能:

    类型:可选择文本或图片水印两种类型,默认为文本。
    忽略:当图片尺寸小于该设定值时,则不添加水印。
    位置:设置水印的9个位置,默认为右下角。
    水平调校、垂直调校:调整水印的水平和垂直偏移。负值表示左偏移或上偏移。
    字体:由于字体文件较大,插件只内置了几种字体,用户可自行上传.ttf字体文件到 wp-content/uploads/dw-uploads/fonts/ 目录。
    文本:输入水印显示的文本。
    大小:输入文本水印显示的大小。
    颜色:在弹出的色盘中选择文本水印的颜色。
    透明度:0表示全透明,100表示不透明。
    插件后台提供预览功能,用户可预览效果后再保存。


    下载地址

    插件推荐2:image-watermark


    image-watermark 亮点功能在于可以把你之前已上传的图片也加上水印。功能上同样支持加水印的位置,并能控制透明度。

    image-watermark支持的功能:

    选择水印位置;
    可调透明度;
    新旧上传图片均可打水印;
    禁止图片右键点击复制。


    下载地址

    image-watermark汉化版地址:https://www.lanzous.com/i6jzuni

    类似的插件还有好几款,都是大同小异,上面这两款是网友用过比较不错的,还是免费的。

    插件推荐3:WPWaterMark


    WPWaterMark是国人博主老蒋制作的一款给WordPress添加水印的插件,完全中文。

    基于WordPress程序且免费提供给用户使用,加强图片水印功能,防止文章和图片被盗,至少保留水印,加强防盗能力;
    可选择九宫格、随机九宫格、满铺水印三种效果,至少是目前全网少有的插件之一;
    轻水印插件支持设置文字、图片水印,可以设置旋转角度和透明度等常规功能。
    下载地址 github下载

    WordPress上传图片添加水印免插件方法:


    如果你觉得安装WordPress插件浪费资源,那么你也可以使用下面的方法手动创建一个文件来自动添加图片水印(其实和插件的道理一样)

    1.在主题目录里面新建class文件夹,然后把 image.php 文件放进去

    2.打开 functions.php 文件,添加下面的代码:

    参考:安全添加代码到functions.php文件的方法:Code Snippets

    /**

    • WordPress上传图片添加水印
      */
      function uimoban_watermark($attachment_ID)
      {
      $attachment = get_post($attachment_ID);
      switch($attachment->post_mime_type){
      case ‘image/jpeg’:
      case ‘image/png’:
      case ‘image/gif’:
      require THEME_FILES . ‘/class/image.php’;
      $image = new image(true);
      $image->set(‘watermark.png’, 1);
      $image->watermark($attachment->guid);
      break;
      default:return ;
      }
      }
      add_action(‘add_attachment’, ‘uimoban_watermark’);

      说明:$image->set(‘watermark.png’, 1); 中watermark.png指定的是水印图片,和第一步代码中的data/watermark/目录下的watermark.png应该保持一致,当然你也可以自行修改。“1”代表水印位置。

    WordPress又拍云/七牛添加水印方法:
    有些用户用的是又拍云/七牛的图床,又拍云/七牛本身是支持水印设置的,想让Wordpress调用添加水印的图片,还需要通过下面的方法。

    又拍云自动添加水印
    1.打开 functions.php 文件,添加下面的代码:

    /**

    • 又拍云图片添加水印
      */
      function fa_hack_image_url($matches) {
      $prefix = ‘!boob’;// 自定义版本或者水印字符串
      return $matches[1] . $matches[‘2’] . $prefix;
      }

    function fa_image_add_watermelon( $content ){
    $content = preg_replace_callback(“/(]*src *= [\”‘]?)([^\”‘])/i”, ‘fa_hack_image_url’ , $content);
    return $content;
    }
    add_filter(‘the_content’,’fa_image_add_watermelon’);

    2.然后设置又拍云水印规则,在创建缩略图里面设置水印。

    生成的水印地址,可以自行拼接url地址:

    /watermark/url/水印路径base64/align/southeast

    其中水印路径需要base64编码,比如路径为/watermark.png,转换为base64后为L3dhdGVybWFyay5wbmc=,则图片需要加的后缀为 :

    !/watermark/url/L3dhdGVybWFyay5wbmc=/align/southeast

    align后面为方向,可以根据你自己的需要调整,当然最简单的是直接在新建规则的时候设置了。

    七牛自动添加水印
    1.打开 functions.php 文件,添加下面的代码:

    add_filter(‘the_content’, ‘QiNiuThumbnail’);
    function QiNiuThumbnail($content) {
    global $post;
    $pattern =”/<img(.?)src=(‘|\”)(.?).(bmp|gif|jpeg|jpg|png)(‘|\”)(.?)>/i”; / 下面这行代码中的300表示缩略图的大小,请根据实际需求修改即可 / $replacement = ”; $content = preg_replace($pattern, $replacement, $content); / 此处预留位置,可删除 */
    return $content;
    }

    PS:以上代码里,?imageMogr2/thumbnail/300x 自行替换为所需字符以完成图片处理。

    2.在七牛后台建立新建图片样式,然后创建图片水印样式,也可以是文字水印。

    以上方法参考了 张戈博客 和 fatesinger。

    如果你不嫌麻烦的话,也可以手动给图片添加水印,在线添加水印工具 或者 PS,因为有时候自动加水印,水印可能会盖掉图片中重要的地方。

    电脑上批量给图片添加水印的话你可以使用XnConvert这款软件:

    Mac批量处理图片修改大小、加水印、旋转的方法(有Windows版本的,文章当初写的mac版本而以。)

  • 研究胖鼠采集(Fat Rat Collect)会员功能破解限制

    研究胖鼠采集(Fat Rat Collect)会员功能破解限制

    对象:胖鼠采集(Fat Rat Collect)v2.4.3 ;本文章综合整理于互联网,已测试有效,但本着尊重和希望应用者支持原作者,才是长久之计,支持并给他打赏!

    胖鼠采集(Fat Rat Collect) 是一款能帮助你网站文章采集自动化的好帮手. 开源免费, 支持所有网站列表详情页面 它有列表批量自动采集,自动发布,自动打标签,等黑科技功能, 一次创建规则, 后续省心省力

    胖鼠采集官方网站:https://www.fatrat.cn/

    1、突破采集3页限制:

    虽然可以突破3页的采集,但是延时的问题还是会存在采集不完全,需多次采集,或修改文件中的延时时间:60秒

    fat-rat-collect\includes\fatrat-spider.php

    修改该处即可:

                if (!get_option(FRC_Validation::FRC_VALIDATION_SPONSORSHIP) && count($page_count) > 3){
                    return ['code' => FRC_ApiError::FAIL, 'msg' => FRC_Validation::FRC_HINT_F];
                }

    2、采集后发布到指定目录:

    查找“FRC_HINT_L”,跟踪到fat-rat-collect\includes\fatrat-options.php

            if (get_option(FRC_Validation::FRC_VALIDATION_RELEASE_CONTROL)){
                $params = [
                    'category' => frc_sanitize_array('release_category', 'integer'),
                    'user' => frc_sanitize_array('release_user', 'integer'),
                    'status' => frc_sanitize_text('release_status', 'pending'),
                    'type' => frc_sanitize_text('release_type', 'post'),
                    'thumbnail' => frc_sanitize_text('release_thumbnail', 'thumbnail1'),
                    'release_type' => frc_sanitize_text('release_type', 'WordPress'),
                    'extension_field' => frc_sanitize_text('extension_field', 'post'),
                ];
    
                if (empty($params['category'])){
                    $params['category'] = array(1);
                }
    
                if (empty($params['user'])){
                    $params['user'] = [get_current_user_id()];
                }
            } else {
                $msg = FRC_Validation::FRC_HINT_L;
                $params = [
                    'category' => array(1),
                    'user' => [get_current_user_id()],
                    'status' => frc_sanitize_text('release_status', 'pending'),
                    'thumbnail' => 'thumbnail2',
                    'release_type' => 'WordPress',
                    'type' => 'post',
                    'extension_field' => 'post',
                ];
            }

    修改位置:

    [content_hide]

    在数据库表wp_options中添加一项FRC_VALIDATION_RELEASE_CONTROL
    ,值任意就好,我是写的1

    [/content_hide]

    wordpress主题开发函数2:添加选项add_option()与修改选项update_option()

    办法1:

    SELECT wp_term_relationships.object_id FROM `wp_term_relationships` WHERE wp_term_relationships.object_id in (select wp_posts.ID from `wp_posts` where `wp_posts`.`ID`=wp_term_relationships.object_id )AND wp_term_relationships.term_taxonomy_id = 1

    UPDATE `wp_term_relationships` SET wp_term_relationships.term_taxonomy_id =445 WHERE wp_term_relationships.object_id in (select wp_posts.ID from `wp_posts` where `wp_posts`.`ID`=wp_term_relationships.object_id )AND wp_term_relationships.term_taxonomy_id = 1

    3、时间限制:

    数据库中wp_options中的字段frc_report_permissions_time值,先修改了再说:

    4、胖鼠工具箱-自动采集(自动发布)-时间频率突破:

    未破解前,为灰色:

    代码位置:\fat-rat-collect\includes\fatrat-kit.php,268行、293行

                    <h4>自动采集</h4>
                    <ul>
                        <?php $cron_spider = get_option('frc_cron_spider'); ?>
                        <li><input type="radio" name="frc_cron_spider" value="" <?php echo empty($cron_spider) ? 'checked' : '' ?>> 关闭此功能</li>
                        <?php foreach ($frc_wp_schedules as $key => $info){
                            $disabled = '';
                            if (empty($frc_validation_sponsorship) && $info['interval']<43200){
                                $disabled = 'disabled';
                            }
                            echo (sprintf('<li><input type="radio" name="frc_cron_spider" value="%s" %s %s> %s(%s秒)</li>', $key, (!empty($cron_spider) && $cron_spider == $key ? esc_html('checked') : ''), $disabled, $info['display'], $info['interval']));
                        } ?>
                    </ul>
    

    [content_hide]

    修改43200为0即可.

    [/content_hide]

    5、自动标签功能

    \fat-rat-collect\includes\fatrat-kit.php,303行

    同文件,第138行:

    需要在wp_options创建字段,且内容为json格式:

    [content_hide]

    字段名:FRC_VALIDATION_AUTO_TAGS

    值:{"switch":open,"created_at":"1617073742"}


    [/content_hide]

    6、标签内链:

    增加字段

    [content_hide]

    FRC_VALIDATION_INNER_CHAIN

    {"switch":open,"created_at":1617333683,"limit":1,"hide_empty":1,"created_at":1}


    [/content_hide]

    7、修改配置数量的限制

    找到文件:fatrat-options.php:做以下修改即可!

    [content_hide]

    搜索找到(count($this->options()) >= 5;修改5为更大的数值即可。

    [/content_hide]

    8、修改数据通详情页面展示数据条数

    找到文件:fatrat-data-detail.php,做以下修改即可!

    查找以下字段:

    [content_hide]

    $per_page = $this->get_items_per_page(‘snippets_per_page’, 10);

    修改10为你要的条数。

    [/content_hide]

    9、其他都差不多

    其他都OK了 但是关键词随机插入不行:

    字段内容修改为:{“switch”:open,”created_at”:1617333683,”limit”:1,”hide_empty”:1,”created_at”:1}

    10、最后可用模式数据库内容:

    11、最后

    作者还是很厚道的,小菜也过了一把瘾,对原作者的红包赞助还是不能少的。

  • wordpress给同一类型文章自动添加特色图片

    wordpress给同一类型文章自动添加特色图片

    wordpress作为常见的网站框架,使用率很高。但是大部分使用wordpress的用户没有太多php基础,所以在修改源码上会有一些难处。有很多人会使用DJD等投稿插件,但是又会关闭许多编辑器的功能,所以我们需要通过修改php文件的方式,给特定类型的文章自动添加特色图片,这骗经验分享给wordpress使用者们。

    首先在wordpress中新建某一类型的文章,用于做实验。比如我在这里新建一种类型叫做”有渔编程”的文章类型。注意如果没有修改过wp-config.php命名规则的话,最好设定别名为英文名。

    新建好文章类型后,在类型中选择对应文章类型下方的编辑按钮。这时候可以看到浏览器下方出现的链接,通过肉眼查找tag_ID=的方法,这个数字就是该类型的ID。比如我的类型就是3,记住这个值。

    开发人员在Theme文件夹中找到function.php,普通用户在wordpress–>外观–>编辑,然后右边菜单栏中找到function.php就可以了。

    1. 编辑function.php文件。首先定义一个upload_image函数。具体写法如下:function upload_image(){global $post;}先定义post作为传导函数,定义为全局函数,这样才能调用在任何情况下触发post行为。
    2. 首先来判断用户有没有上传特色图片,因为如果是用wordpress作站的话,大部分特色图片还是用户自己设定的,避免干扰。表达式为$already_has_thumb = has_post_thumbnail($post->ID);直接加在刚才那句下面就行。
    3. 加上限定条件,因为我们是要在“有渔”这个栏目下的文章上加上特色图片,所以需要wordpress自带的判定函数。因为第二步我们已经知道了我们的类型是3,所以只需要填入if(is_category(‘3’)) {}
    4. 再加一层判断,判定其是否有特色图片。代码为if (!$already_has_thumb)  {}这一层是为了防止用户自己设置了特色图片。
    5. 这里的42是我要设置的封面图的id,你可以通过类似第二步的方法获取图像的ID,显示为post=ID.set_post_thumbnail($post->ID, 42);
    6. 函数构建完成,在function中对其进行调用。add_action(‘the_post’, ‘upload_image’);add_action(‘save_post’, ‘upload_image’);add_action(‘draft_to_publish’, ‘upload_image’);add_action(‘new_to_publish’, ‘upload_image’);add_action(‘pending_to_publish’, ‘upload_image’);最后一个是最重要的,因为我们的目标就是让投稿用户,尤其是DJD投稿用户不需要设置特色图片也能拥有。保存文件。
    7. 10回到控制面板,发布两篇文章做测试。

    最后汇总,代码如下:

    function upload_image(){
    global $post;
    $already_has_thumb = has_post_thumbnail($post->ID);
    if(is_category('3')) {
    if (!$already_has_thumb)  {
    set_post_thumbnail($post->ID, 42);
    }
    }
    }
    add_action('the_post', 'upload_image');
    add_action('save_post', 'upload_image');
    add_action('draft_to_publish', 'upload_image');
    add_action('new_to_publish', 'upload_image');
    add_action('pending_to_publish', 'upload_image');
  • 胖鼠采集 WordPress优秀开源采集插件

    胖鼠采集 WordPress优秀开源采集插件

    • 微信公众号文章采集 – 强大的Jquery可以处理各种版权信息, 纵享丝滑.
    • 简书文章采集 – 强大的Jquery可以处理内容各种图片, 柔顺到底.
    • 知乎问答采集 – 强大的Jquery可以处理各种你不想要的东西, 一键爽歪歪.
    • (独家主打) 列表采集,历史采集 视频文字教程- 只需轻轻一点. 数不清的文章就来了.
    • (独家主打) 详情页面文章采集 – 任何网站十秒搞定
    • (独家主打) 分页爬取 – 历史数据, 也不放过. 一网打尽
    • (胖鼠主打) 自动采集 – 一键启动不放过每一份数据.
    • (胖鼠主打) 自动发布 – 您省心省力好帮手.
    • (独家主打) 调试模式 – 新建规则好帮手, 采集结果好伙伴.
    • (独家主打) 体验例子 – 一键体验胖鼠.
    • (主打主打) 文章自动添加, 动态内容, 自动标签, 标签内链, 优化SEO.
    • (胖鼠采集) 文章滤重 – 支持.
    • (胖鼠采集) 自动特色图片 – 支持.
    • (胖鼠采集) 采集图片加入媒体库 – 支持.
    • (胖鼠采集) 数据处理 – 完美支持Html Jquery
    • (胖鼠采集) 内容关键字过滤替换 伪原创 – 支持.
    • (胖鼠采集) 自定义采集任何可见网站 – 完美支持.
    • (胖鼠采集) 自定义文章图片链接类型 – 支持.
    • (重磅重磅) 胖鼠采集完全基于Wordpress, 安装即用, 开源作品
    • (声明声明) 如你的PHP版本小于PHP71, 请移步胖鼠采集的Github下载使用胖鼠v5版本 分支名: based_php_5.6
    • (声明声明) 胖鼠采集初衷为参考学习交流; 请大家遵纪守法. 抵制违法犯罪, 作者不承担任何法律风险.
    • (声明声明) 胖鼠采集开源可供您查阅代码, 或者二次开发使用供您使用, 但不可修改源码后用于商业行为.
    • …

    安装

    • 在插件中搜索 胖鼠采集 安装即可
    • 将插件文件上传到/wp-content/plugins/目录 即可
    • PHP版本小于PHP71, 请移步胖鼠采集的Github下载使用胖鼠v5版本 分支名: based_php_5.6
    • 推荐环境
    • PHP7.2 或 PHP7.3
    • MYSQL5.7 或 MYSQL5.6

    系统分为五大块.

    • 胖鼠强大的爬虫中心
    • 支撑胖鼠的配置中心
    • 发布文章的数据桶
    • 调试中心debugging
    • 工具箱特色小工具

    GITHUB地址:https://github.com/KitePig/FatRat-Collect

  • 产品信息被批量采集怎么解决?这几个狠招90%能防止采集

    近一两年中,“内容为王”被越来越多的互联网人所提及,就连BAT这些大佬级别的公司,也开始在内容领域投入大量的人力财力,各种资源内容层出不穷。但在这个时期,很多产品因风控意识不强、版权意识不足等问题,导致了大量核心资源外泄。今天我们就来简单聊聊如何防止这些“无形的偷盗者”。(此篇非技术篇,技术大神们手下留情)

    偷盗者常用的盗窃手段

    在文章开始,我们先简单聊聊我理解的恶意采集。所谓的恶意采集,就是将别家网站的图片、文字、视频、音频等资源下载至自家服务器,经简单处理后放入自家网站使用的过程。从这个定义中,我们可以看到,恶意采集是一种损人利己的行为。但是类似于百度蜘蛛、google蜘蛛这种可以带来流量的采集,我们不将他计入恶意采集的范畴。

    网站内容刚写出来直接就被采集,或者分分钟被别人抄走,是不是很心痛?心痛就对了,因为更心痛的还在后面,你的内容被批量复制或者镜像,等待你的可能只是失望、无能为力,甚至麻木,那么正确姿势应该是什么呢?

    一、防止小白采集

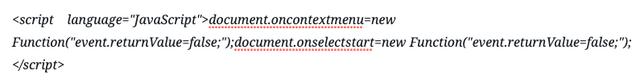
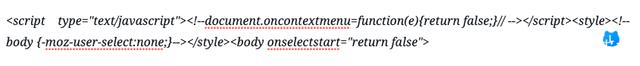
    这种方式就是防止小白,小白一般也就会简单的复制粘贴,所以我们就把复制粘贴锁定就好,一般会用到这两种:

    dede防止右键代码:

    wordpress防止禁用右键代码

    或者使用WPCopyRights插件

    二、防止中高级采集

    一般采集规整是判断该文章的唯一性后,写出正则表达式批量采集,如果增加混淆代码,可能采集工具就没有那么顺利了,比如我们在织梦文章class后面增加文章id值,这样可以防止一部分采集,另外wordpress中也可以这样操作,加入类似的代码。

    三、心里震慑

    很多站长没有技术或者从技术上不能有效防止采集,那么我们可以从法律层面去进行操作,比如你去找一家事务所合作,然后根据你目前的需求,制定对应的法律声明,然后放在显眼的位置,这样在心里可以震慑到采集者。

    接下来进入正题,我们来看看采集者通常是通过什么手段来采集我们的资源的。

    盗取下载链接

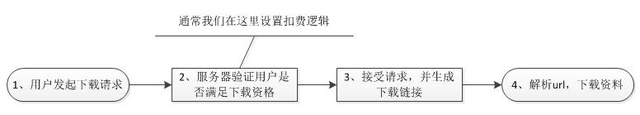
    这种盗取方式很好理解,在很多下载网站中(如百度文库、道客巴巴、21世纪教育网),当用户去请求下载的时候,服务器通常会返回一个下载链接给浏览器,用于下载。在这个过程中,采集者会将链接拦截下来,进行相应的解析,再通过脚本执行自动下载。喝杯茶的功夫,资源已经被采集走了。

    盗取页面的内容

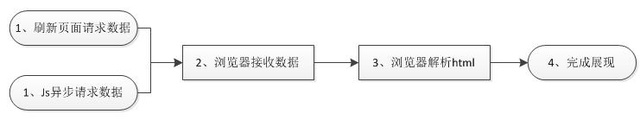
    很多网站为了用户体验,通常会将一部分想看到的数据,直接加载在页面上,让用户进行查看。这时候采集者只需要解析页面的html结构,就能将页面的信息全部采集下来。百度爬虫、快照、页面采集基本上都是用了这个原理。

    直接盗取web数据库

    这个就比较高级了,采集者通常会编写一个爬虫,让爬虫自动发现网站上的查询接口,并且模拟接口的数据标准,向接口传输相应的查询指令,最后将返回的数据进行整理处理,就完成了相应的资源采集。

    手动采集

    手动采集从字面上理解,就是通过人工进行资源的采集,这种方式适用范围比较灵活,可以通过资源下载、复制等人工方式进行资源的采集。这种方式看着很low,效率很低。但往往这种采集方式,让人无比头疼。

    PS:1个用户在A网站下载了一份word资料,经过简单编辑后,上传到自己的网站上进行使用。这个过程就无法通过技术手段进行跟踪(整个过程全是用户的真实操作),即使发现了这种现象,也无法确定对方盗取了自己的资源,因为你没有切实可行的证据。此处大家可以思考一下,百度文库的一部分内容是怎么来的。

    防采集方法策略

    上文中简单介绍了部分采集者的采集手段,接下来我们聊聊该如何进行防采集处理。

    应对下载链接泄露的策略

    上图为一份资料的下载流程,通过这个流程,我们发现,如果采集者可以直接拿到步骤3的下载链接,是可以不需要经过步骤2的验证,直接下载资源。这样我们就清楚了,要防止这种采集方式的话,我们的重点在于不让用户拿到资源的下载链接。那我们就可以按照下面的方式进行处理:

    将下载链接进行加密

    程序猿在开发过程中,基本都会进行下载链接的加密处理。加密就好比一把钥匙,没有钥匙就开不了锁,加密一样的,不知道解密方式,是无法破解你的下载链接,这样便实现了资源的防采集。

    解密是需要知道加密规则的,所以在做加密处理的时候,最好不要使用第三方机加密规则,自己做最安全。定期维护加密规则,也是有必要的。

    防止采集者拦截下载链接

    有一部分采集者,会在步骤3与步骤4之间,拦截传输出去的下载链接。这样他不需要经过步骤2,一样能拿到我们返回的下载链接进行下载。遇到这种情况的时候,我们可以考虑在下载url加入用户验证。在浏览器解析url的时候,验证当前用户是否是我们的下载用户,达到防采集的目的。除非用户能拿到我们的账户信息,否则是不能采集到我们的内容。但是这种方法无法支持断点下载。

    告诉你一个秘密,将网站升级升https协议,可有效的防止数据的拦截哦。

    应对页面采集的策略

    上图为一个页面完成显示的过程,在这个过程中,我们可以发现,采集者如果要拿到这个页面中的数据,必须进行第1步与第3步。所以我们需要在这两步对采集者进行防范,具体的方式如下:

    限制请求数量

    我们可以通过限制关键数据的请求次数来限制采集者采集数据。这个很好理解,当用户请求数据超过多少次的时候,再次请求,我们将不给他提供相应的数据。这个方法简单粗暴,但是很有效果。在进行限制请求数据的时候,我们需要注意以下几点:

    判断数据请求次数时,必须通过用户名(用户ID)进行判断,不能通过IP地址。IP地址可以伪造,实现1次请求换1个IP都是可以的,所以通过IP地址判断的话,基本没什么效果。

    保证账号的注册难度。很多产品仅开放了通过手机注册账号,即使使用第三方登录,也需要绑定相应的手机号码。这大大增加了采集者获取账号的难度。

    评估用户每日浏览这些关键数据的次数。尽量不影响用户的正常使用。

    提供无法直接使用的数据

    页面中加载的所有内容,采集下来都是可以直接使用的,那怎样提供无法直接使用的数据呢?这里就不绕圈子了,所谓无法直接使用的数据,是因为采集的资源带有部分版权,或者格式必须经过转换才能使用。这样便增加了采集的成本,在一定程度上预防了数据擦剂。

    上图是一个题库产品的试题展示,他把试题中关键的部分(答案解析)用带水印的图片进行代替。当采集者发现要使用这些数据的话,需要将图片记性处理,而且处理难度较大,成本较高。那还会采吗?

    加入干扰数据

    将关键数据的html代码中,加入错误/混乱的数据,利用爬虫采集数据的规则,将干扰(混乱)的信息提供采集爬虫,实现防采集的目的。这种方式会对网站的seo造成影响。

    提供错误数据

    当用户请求数据的次数超过一定频率的时候,再次请求时,可以传输错误的数据给采集者。采集者收录到错误的数据后,会对整批采集的数据都抱有怀疑态度,而不敢使用此批资源。这种采集方式会对seo与用户造成一定的影响,慎用。

    通过用户行为分析来防止采集

    随着技术越来越发达,对用户行为的分析也逐渐成熟。我们可以将这项技术放在我们防采集领域,通过行为分析,判断用户是机器还是正常用户。是机器的话,我们可以根据情况,弹出验证码进行验证,也可以提供错误的数据。

    上述的5种方式,是可以同时进行使用的,例如(1)与(2)合并在一起,在用户未登录的时候提供方案(2),用户已登录时,提供体验更好的方案(1)。更多的组合方式,可以自行进行组合。

    应对页面采集时,需要考虑到seo的问题,千万不要将错误信息提供给爬虫(百度、谷歌等爬虫)。所以如果发现是这些“益虫”在采集数据的时候,尽量提供完整且正确的数据给它们吧。

    应对手动采集的策略

    前文说过,手动采集是最难防的,但是也不是没有应对方式,但是从根本上杜绝,也是很麻烦的。下面我们介绍几种方式:

    、页面内容防复制。通过防复制处理,可避免普通用户复制页面内容,但是稍微懂点技术的人员,此功能是形同虚设的。

    、限制用户每天的下载量。

    、下载的文件中,带有产品的版权信息。视频中带有logo;文件中带水印;文件本身中增加不影响文件使用的标识。当我们的内容被上传到别的网站后,我们可以通过这些标识来维权,并要求对方下架相关资源。

    采用人工检测,封号。

    应对直接攻击web数据库的策略

    程序猿知道这个如何去做,相信你的小组成员,让他去解决吧!

    总结

    此篇文章主要是抛砖引玉,希望通过我的分享,能让大家对防采集有个初步的认识,并应用到相应的产品规划中,增加产品的安全性。

  • 史上最全 Python 爬虫工具列表大全,建议收藏

    史上最全 Python 爬虫工具列表大全,建议收藏

    这个列表包含与网页抓取和数据处理的Python库。

    网络

    • 通用
      • urllib -网络库(stdlib)。
      • requests -网络库。
      • grab – 网络库(基于pycurl)。
      • pycurl – 网络库(绑定libcurl)。
      • urllib3 – Python HTTP库,安全连接池、支持文件post、可用性高。
      • httplib2 – 网络库。
      • RoboBrowser – 一个简单的、极具Python风格的Python库,无需独立的浏览器即可浏览网页。
      • MechanicalSoup -一个与网站自动交互Python库。
      • mechanize -有状态、可编程的Web浏览库。
      • socket – 底层网络接口(stdlib)。
      • Unirest for Python – Unirest是一套可用于多种语言的轻量级的HTTP库。
      • hyper – Python的HTTP/2客户端。
      • PySocks – SocksiPy更新并积极维护的版本,包括错误修复和一些其他的特征。作为socket模块的直接替换。
    • 异步
      • treq – 类似于requests的API(基于twisted)。
      • aiohttp – asyncio的HTTP客户端/服务器(PEP-3156)。

    网络爬虫框架

    • 功能齐全的爬虫
      • grab – 网络爬虫框架(基于pycurl/multicur)。
      • scrapy – 网络爬虫框架(基于twisted),不支持Python3。
      • pyspider – 一个强大的爬虫系统。
      • cola – 一个分布式爬虫框架。
    • 其他
      • portia – 基于Scrapy的可视化爬虫。
      • restkit – Python的HTTP资源工具包。它可以让你轻松地访问HTTP资源,并围绕它建立的对象。
      • demiurge – 基于PyQuery的爬虫微框架。

    HTML/XML解析器

    • 通用
      • lxml – C语言编写高效HTML/ XML处理库。支持XPath。
      • cssselect – 解析DOM树和CSS选择器。
      • pyquery – 解析DOM树和jQuery选择器。
      • BeautifulSoup – 低效HTML/ XML处理库,纯Python实现。
      • html5lib – 根据WHATWG规范生成HTML/ XML文档的DOM。该规范被用在现在所有的浏览器上。
      • feedparser – 解析RSS/ATOM feeds。
      • MarkupSafe – 为XML/HTML/XHTML提供了安全转义的字符串。
      • xmltodict – 一个可以让你在处理XML时感觉像在处理JSON一样的Python模块。
      • xhtml2pdf – 将HTML/CSS转换为PDF。
      • untangle – 轻松实现将XML文件转换为Python对象。
    • 清理
      • Bleach – 清理HTML(需要html5lib)。
      • sanitize – 为混乱的数据世界带来清明。

    文本处理

    用于解析和操作简单文本的库。

    • 通用
    • difflib – (Python标准库)帮助进行差异化比较。
    • Levenshtein – 快速计算Levenshtein距离和字符串相似度。
    • fuzzywuzzy – 模糊字符串匹配。
    • esmre – 正则表达式加速器。
    • ftfy – 自动整理Unicode文本,减少碎片化。
    • 转换
    • unidecode – 将Unicode文本转为ASCII。
    • 字符编码
    • uniout – 打印可读字符,而不是被转义的字符串。
    • chardet – 兼容 Python的2/3的字符编码器。
    • xpinyin – 一个将中国汉字转为拼音的库。
    • pangu.py – 格式化文本中CJK和字母数字的间距。
    • Slug化
    • awesome-slugify – 一个可以保留unicode的Python slugify库。
    • python-slugify – 一个可以将Unicode转为ASCII的Python slugify库。
    • unicode-slugify – 一个可以将生成Unicode slugs的工具。
    • pytils – 处理俄语字符串的简单工具(包括pytils.translit.slugify)。
    • 通用解析器
    • PLY – lex和yacc解析工具的Python实现。
    • pyparsing – 一个通用框架的生成语法分析器。
    • 人的名字
    • python-nameparser -解析人的名字的组件。
    • 电话号码
    • phonenumbers -解析,格式化,存储和验证国际电话号码。
    • 用户代理字符串
    • python-user-agents – 浏览器用户代理的解析器。
    • HTTP Agent Parser – Python的HTTP代理分析器。

    特定格式文件处理

    解析和处理特定文本格式的库。

    • 通用
    • tablib – 一个把数据导出为XLS、CSV、JSON、YAML等格式的模块。
    • textract – 从各种文件中提取文本,比如 Word、PowerPoint、PDF等。
    • messytables – 解析混乱的表格数据的工具。
    • rows – 一个常用数据接口,支持的格式很多(目前支持CSV,HTML,XLS,TXT – 将来还会提供更多!)。
    • Office
    • python-docx – 读取,查询和修改的Microsoft Word2007/2008的docx文件。
    • xlwt / xlrd – 从Excel文件读取写入数据和格式信息。
    • XlsxWriter – 一个创建Excel.xlsx文件的Python模块。
    • xlwings – 一个BSD许可的库,可以很容易地在Excel中调用Python,反之亦然。
    • openpyxl – 一个用于读取和写入的Excel2010 XLSX/ XLSM/ xltx/ XLTM文件的库。
    • Marmir – 提取Python数据结构并将其转换为电子表格。
    • PDF
    • PDFMiner – 一个从PDF文档中提取信息的工具。
    • PyPDF2 – 一个能够分割、合并和转换PDF页面的库。
    • ReportLab – 允许快速创建丰富的PDF文档。
    • pdftables – 直接从PDF文件中提取表格。
    • Markdown
    • Python-Markdown – 一个用Python实现的John Gruber的Markdown。
    • Mistune – 速度最快,功能全面的Markdown纯Python解析器。
    • markdown2 – 一个完全用Python实现的快速的Markdown。
    • YAML
    • PyYAML – 一个Python的YAML解析器。
    • CSS
    • cssutils – 一个Python的CSS库。
    • ATOM/RSS
    • feedparser – 通用的feed解析器。
    • SQL
    • sqlparse – 一个非验证的SQL语句分析器。
    • HTTP
    • HTTP
    • http-parser – C语言实现的HTTP请求/响应消息解析器。
    • 微格式
    • opengraph – 一个用来解析Open Graph协议标签的Python模块。
    • 可移植的执行体
    • pefile – 一个多平台的用于解析和处理可移植执行体(即PE)文件的模块。
    • PSD
    • psd-tools – 将Adobe Photoshop PSD(即PE)文件读取到Python数据结构。

    自然语言处理

    处理人类语言问题的库。

    • NLTK -编写Python程序来处理人类语言数据的最好平台。
    • Pattern – Python的网络挖掘模块。他有自然语言处理工具,机器学习以及其它。
    • TextBlob – 为深入自然语言处理任务提供了一致的API。是基于NLTK以及Pattern的巨人之肩上发展的。
    • jieba – 中文分词工具。
    • SnowNLP – 中文文本处理库。
    • loso – 另一个中文分词库。
    • genius – 基于条件随机域的中文分词。
    • langid.py – 独立的语言识别系统。
    • Korean – 一个韩文形态库。
    • pymorphy2 – 俄语形态分析器(词性标注+词形变化引擎)。
    • PyPLN – 用Python编写的分布式自然语言处理通道。这个项目的目标是创建一种简单的方法使用NLTK通过网络接口处理大语言库。

    浏览器自动化与仿真

    • selenium – 自动化真正的浏览器(Chrome浏览器,火狐浏览器,Opera浏览器,IE浏览器)。
    • Ghost.py – 对PyQt的webkit的封装(需要PyQT)。
    • Spynner – 对PyQt的webkit的封装(需要PyQT)。
    • Splinter – 通用API浏览器模拟器(selenium web驱动,Django客户端,Zope)。

    多重处理

    • threading – Python标准库的线程运行。对于I/O密集型任务很有效。对于CPU绑定的任务没用,因为python GIL。
    • multiprocessing – 标准的Python库运行多进程。
    • celery – 基于分布式消息传递的异步任务队列/作业队列。
    • concurrent-futures – concurrent-futures 模块为调用异步执行提供了一个高层次的接口。

    异步

    异步网络编程库

    • asyncio – (在Python 3.4 +版本以上的 Python标准库)异步I/O,时间循环,协同程序和任务。
    • Twisted – 基于事件驱动的网络引擎框架。
    • Tornado – 一个网络框架和异步网络库。
    • pulsar – Python事件驱动的并发框架。
    • diesel – Python的基于绿色事件的I/O框架。
    • gevent – 一个使用greenlet 的基于协程的Python网络库。
    • eventlet – 有WSGI支持的异步框架。
    • Tomorrow – 异步代码的奇妙的修饰语法。

    队列

    • celery – 基于分布式消息传递的异步任务队列/作业队列。
    • huey – 小型多线程任务队列。
    • mrq – Mr. Queue – 使用redis & Gevent 的Python分布式工作任务队列。
    • RQ – 基于Redis的轻量级任务队列管理器。
    • simpleq – 一个简单的,可无限扩展,基于Amazon SQS的队列。
    • python-gearman – Gearman的Python API。

    云计算

    • picloud – 云端执行Python代码。
    • http://dominoup.com – 云端执行R,Python和matlab代码。

    电子邮件

    电子邮件解析库

    • flanker – 电子邮件地址和Mime解析库。
    • Talon – Mailgun库用于提取消息的报价和签名。

    网址和网络地址操作

    解析/修改网址和网络地址库。

    • URL
      • furl – 一个小的Python库,使得操纵URL简单化。
      • purl – 一个简单的不可改变的URL以及一个干净的用于调试和操作的API。
      • urllib.parse – 用于打破统一资源定位器(URL)的字符串在组件(寻址方案,网络位置,路径等)之间的隔断,为了结合组件到一个URL字符串,并将“相对URL”转化为一个绝对URL,称之为“基本URL”。
      • tldextract – 从URL的注册域和子域中准确分离TLD,使用公共后缀列表。
    • 网络地址
      • netaddr – 用于显示和操纵网络地址的Python库。

    网页内容提取

    提取网页内容的库。

    • HTML页面的文本和元数据
      • newspaper – 用Python进行新闻提取、文章提取和内容策展。
      • html2text – 将HTML转为Markdown格式文本。
      • python-goose – HTML内容/文章提取器。
      • lassie – 人性化的网页内容检索工具
      • micawber – 一个从网址中提取丰富内容的小库。
      • sumy -一个自动汇总文本文件和HTML网页的模块
      • Haul – 一个可扩展的图像爬虫。
      • python-readability – arc90 readability工具的快速Python接口。
      • scrapely – 从HTML网页中提取结构化数据的库。给出了一些Web页面和数据提取的示例,scrapely为所有类似的网页构建一个分析器。
    • 视频
      • youtube-dl – 一个从YouTube下载视频的小命令行程序。
      • you-get – Python3的YouTube、优酷/ Niconico视频下载器。
    • 维基
      • WikiTeam – 下载和保存wikis的工具。

    WebSocket

    用于WebSocket的库。

    • Crossbar – 开源的应用消息传递路由器(Python实现的用于Autobahn的WebSocket和WAMP)。
    • AutobahnPython – 提供了WebSocket协议和WAMP协议的Python实现并且开源。
    • WebSocket-for-Python – Python 2和3以及PyPy的WebSocket客户端和服务器库。

    DNS解析

    • dnsyo – 在全球超过1500个的DNS服务器上检查你的DNS。
    • pycares – c-ares的接口。c-ares是进行DNS请求和异步名称决议的C语言库。

    计算机视觉

    • OpenCV – 开源计算机视觉库。
    • SimpleCV – 用于照相机、图像处理、特征提取、格式转换的简介,可读性强的接口(基于OpenCV)。
    • mahotas – 快速计算机图像处理算法(完全使用 C++ 实现),完全基于 numpy 的数组作为它的数据类型。

    代理服务器

    • shadowsocks – 一个快速隧道代理,可帮你穿透防火墙(支持TCP和UDP,TFO,多用户和平滑重启,目的IP黑名单)。
    • tproxy – tproxy是一个简单的TCP路由代理(第7层),基于Gevent,用Python进行配置。

    其他Python工具列表

    • awesome-python
    • pycrumbs
    • python-github-projects
    • python_reference
    • pythonidae
  • 百度一键人像分割 API 试用

    百度一键人像分割 API 试用

    近期百度上线了人像抠图 API – 人像分割 – 识别图像中的人体轮廓,与背景进行分离,其主要分析能力为:

    识别人体的轮廓范围,与背景进行分离,适用于拍照背景替换、照片合成、身体特效等场景;

    输入正常人像图片,返回分割后的二值结果图,返回的二值图像需要进行二次处理才可查看分割效果.

    技术和应用场景简单介绍参考 – 人像分割技术正式上线 一键抠像 欢迎免费使用.

    1. 百度人像分割技术简介

    核心能力

    精准识别图像中的人体轮廓边界,将人体轮廓与图像背景进行分离,实现像素级分割,一键抠像.

    技术优势

    • 适应性强:图像中有多个人体,或者背景比较复杂时,都不在话下,还能hold住人体位置重叠、遮挡、背面、侧面、大动作等各类场景.
    • 精准分割:人体轮廓边缘清晰可见,评测IoU 95%以上.

    分割效果图

    应用场景

    • 人像抠图
      将原始图片中的人像分离出来,选择新的背景图像进行替换、合成;同时可以对背景进行虚化处理,突出人像,实现大光圈人像拍照效果。手残党也能变成修图小能手~
    • 人体特效
      视频直播过程中,识别用户的人体轮廓,为人像实时增加各种设定的背景特效、贴纸道具,拉轰、上档次,妥妥的!

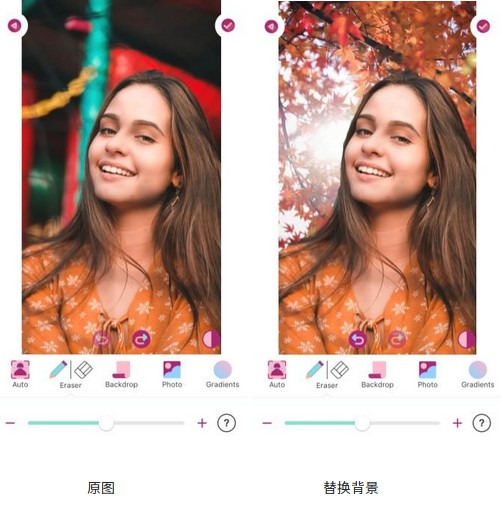
    示例:

    图片去背景

    照片背景替换

    典型案例 – 美啦相机APP

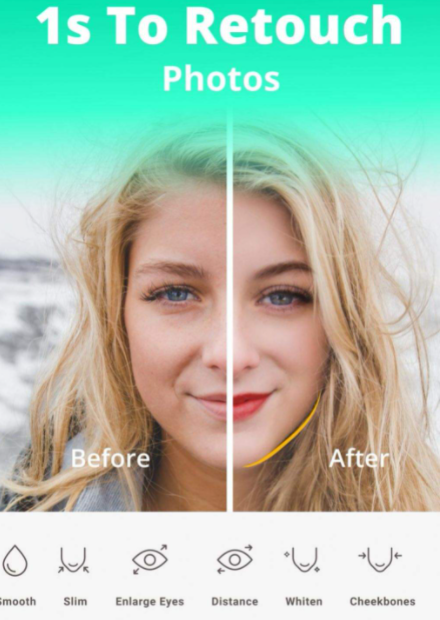
    美啦相机是广州光锥元信息科技有限公司推出的美颜美体应用软件,为女性提供全能的修图服务. 今年8月接入百度人像分割技术,精确分离照片中的人像和背景,为用户提供换背景、给背景添加滤镜、景深模式等定制化个性服务. 一秒就变小仙女~

    如何接入

    人像分割服务已正式上线,欢迎免费试用,请戳这里:http://ai.baidu.com/tech/body/seg

    2. Python 调用百度 API 测试 Demo

    需要首先安装 baidu-aip-2.2.8.0 包

    sudo pip2 install baidu-aip
    # 或
    sudo pip3 install baidu-aip

    百度 API 测试代码如下:

    import cv2
    import base64
    import numpy as np
    
    from aip import AipBodyAnalysis
    
    # 在百度云中申请,每天各接口有 500 次调用限制.
    APP_ID = '****'
    API_KEY = '****'
    SECRET_KEY = '****'
    
    client = AipBodyAnalysis(APP_ID, API_KEY, SECRET_KEY)
    
    imgfile = 'test.jpg'
    ori_img = cv2.imread(imgfile)
    height, width, _ = ori_img.shape
    
    with open(imgfile, 'rb') as fp:
        img_info = fp.read()
    
    seg_res = client.bodySeg(img_info)
    labelmap = base64.b64decode(seg_res['labelmap'])
    nparr = np.fromstring(labelmap, np.uint8)
    labelimg = cv2.imdecode(nparr,1)
    labelimg = cv2.resize(labelimg,(width,height), interpolation=cv2.INTER_NEAREST)
    new_img = np.where(labelimg==1, 255, labelimg)
    maskfile = imgfile.replace('.jpg', '_mask.png')
    cv2.imwrite(maskfile, new_img)
    
    res_imgfile = imgfile.replace('.jpg', '_res.jpg')
    result = cv2.bitwise_and(ori_img, new_img)
    cv2.imwrite(res_imgfile, result)
    
    print('Done.')

    随便从淘宝上找了几张模特图,测试结构如下:

    总结:

    根据 API 输出结果解析出来的 shape 为 473x473x3,应该采用了类似于 PSPNet 的语义分割网络做的二类分割背景人体背景+人体.

    测试结果感觉差强人意.

  • iOS GPUImage实现美颜相机功能(优秀)

    iOS GPUImage实现美颜相机功能(优秀)

    本文介绍了如何使用 GPUImage 来实现一个简单的相机。具体功能包括拍照、录制视频、多段视频合成、实时美颜、自定义滤镜实现等。

    前言

    AVFoundation 是苹果提供的用于处理基于时间的媒体数据的一个框架。我们想要实现一个相机,需要从手机摄像头采集数据,离不开这个框架的支持。GPUImage 对 AVFoundation 做了一些封装,使我们的采集工作变得十分简单。

    另外,GPUImage 的核心魅力还在于,它封装了一个链路结构的图像数据处理流程,简称滤镜链。滤镜链的结构使得多层滤镜的叠加功能变得很容易实现。

    在下面介绍的功能中,有一些和 GPUImage 本身的关系并不大,我们是直接调用 AVFoundation 的 API 来实现的。但是,这些功能也是一个相机应用必不可少的一部分。所以,我们也会简单讲一下每个功能的实现方式和注意事项。

    滤镜链简介

    在 GPUImage 中,对图像数据的处理都是通过建立滤镜链来实现的。

    这里就涉及到了一个类 GPUImageOutput 和一个协议 GPUImageInput 。对于继承了 GPUImageOutput 的类,可以理解为具备输出图像数据的能力;对于实现了 GPUImageInput 协议的类,可以理解为具备接收图像数据输入的能力。

    顾名思义,滤镜链作为一个链路,具有起点和终点。根据前面的描述,滤镜链的起点应该只继承了 GPUImageOutput 类,滤镜链的终点应该只实现了 GPUImageInput 协议,而对于中间的结点应该同时继承了 GPUImageOutput 类并实现了 GPUImageInput 协议,这样才具备承上启下的作用。

    一、滤镜链起点

    在 GPUImage 中,只继承了 GPUImageOutput,而没有实现 GPUImageInput 协议的类有六个,也就是说有六种类型的输入源:

    1、GPUImagePicture

    GPUImagePicture 通过图片来初始化,本质上是先将图片转化为 CGImageRef,然后将 CGImageRef 转化为纹理。

    2、GPUImageRawDataInput

    GPUImageRawDataInput 通过二进制数据初始化,然后将二进制数据转化为纹理,在初始化的时候需要指明数据的格式(GPUPixelFormat)。

    3、GPUImageTextureInput

    GPUImageTextureInput 通过已经存在的纹理来初始化。既然纹理已经存在,在初始化的时候就不会重新去生成,只是将纹理的索引保存下来。

    4、GPUImageUIElement

    GPUImageUIElement 可以通过 UIView 或者 CALayer 来初始化,最后都是调用 CALayer 的 renderInContext: 方法,将当前显示的内容绘制到 CoreGraphics 的上下文中,从而获取图像数据。然后将数据转化为纹理。简单来说就是截屏,截取当前控件的内容。

    这个类可以用来实现在视频上添加文字水印的功能。因为在 OpenGL 中不能直接进行文本的绘制,所以如果我们想把一个 UILabel 的内容添加到滤镜链里面去,使用 GPUImageUIElement 来实现是很合适的。

    5、GPUImageMovie

    GPUImageMovie 通过本地的视频来初始化。首先通过 AVAssetReader 来逐帧读取视频,然后将帧数据转化为纹理,具体的流程大概是:AVAssetReaderOutput -> CMSampleBufferRef -> CVImageBufferRef -> CVOpenGLESTextureRef -> Texture 。

    6、GPUImageVideoCamera

    GPUImageVideoCamera 通过相机参数来初始化,通过屏幕比例和相机位置(前后置) 来初始化相机。这里主要使用 AVCaptureVideoDataOutput 来获取持续的视频流数据输出,在代理方法 captureOutput:didOutputSampleBuffer:fromConnection: 中可以拿到 CMSampleBufferRef ,将其转化为纹理的过程与 GPUImageMovie 类似。

    然而,我们在项目中使用的是它的子类 GPUImageStillCamera。 GPUImageStillCamera 在原来的基础上多了一个 AVCaptureStillImageOutput,它是我们实现拍照功能的关键,在 captureStillImageAsynchronouslyFromConnection:completionHandler: 方法的回调中,同样能拿到我们熟悉 CMSampleBufferRef。

    简单来说,GPUImageVideoCamera 只能录制视频,GPUImageStillCamera 还可以拍照, 因此我们使用 GPUImageStillCamera 。

    二、滤镜

    滤镜链的关键角色是 GPUImageFilter,它同时继承了 GPUImageOutput 类并实现了 GPUImageInput 协议。GPUImageFilter 实现承上启下功能的基础是「渲染到纹理」,这个操作我们在 《使用 iOS OpenGL ES 实现长腿功能》 一文中已经介绍过了,简单来说就是将结果渲染到纹理而不是屏幕上。

    这样,每一个滤镜都能把输出的纹理作为下一个滤镜的输入,实现多层滤镜效果的叠加。

    三、滤镜链终点

    在 GPUImage 中,实现了 GPUImageInput 协议,而没有继承 GPUImageOutput 的类有四个:

    1、GPUImageMovieWriter

    GPUImageMovieWriter 封装了 AVAssetWriter,可以逐帧从帧缓存的渲染结果中读取数据,最后通过 AVAssetWriter 将视频文件保存到指定的路径。

    2、GPUImageRawDataOutput

    GPUImageRawDataOutput 通过 rawBytesForImage 属性,可以获取到当前输入纹理的二进制数据。

    假设我们的滤镜链在输入源和终点之间,连接了三个滤镜,而我们需要拿到第二个滤镜渲染后的数据,用来做人脸识别。那我们可以在第二个滤镜后面再添加一个 GPUImageRawDataOutput 作为输出,则可以拿到对应的二进制数据,且不会影响原来的渲染流程。

    3、GPUImageTextureOutput

    这个类的实现十分简单,提供协议方法 newFrameReadyFromTextureOutput:,在每一帧渲染结束后,将自身返回,通过 texture 属性就可以拿到输入纹理的索引。

    4、GPUImageView

    GPUImageView 继承自 UIView,通过输入的纹理,执行一遍渲染流程。这次的渲染目标不是新的纹理,而是自身的 layer 。

    这个类是我们实现相机功能的重要组成部分,我们所有的滤镜效果,都要依靠它来呈现。

    功能实现

    一、拍照

    拍照功能只需调用一个接口就能搞定,在回调方法中可以直接拿到 UIImage。代码如下:

    - (void)takePhotoWtihCompletion:(TakePhotoResult)completion {
        GPUImageFilter *lastFilter = self.currentFilterHandler.lastFilter;
        [self.camera capturePhotoAsImageProcessedUpToFilter:lastFilter withCompletionHandler:^(UIImage *processedImage, NSError *error) {
            if (error && completion) {
                completion(nil, error);
                return;
            }
            if (completion) {
                completion(processedImage, nil);
            }
        }];
    }


    值得注意的是,相机的预览页面由 GPUImageView 承载,显示的是整个滤镜链作用的结果。而我们的拍照接口,可以传入这个链路上的任意一个滤镜,甚至可以在后面多加一个滤镜,然后拍照接口会返回对应滤镜的渲染结果。即我们的拍照结果不一定要和我们的预览一致。

    示意图如下:

    [图片上传失败…(image-68bb82-1610618344597)]

    <figcaption style=”box-sizing: border-box; display: block;”></figcaption>

    二、录制视频

    1、单段录制

    录制视频首先要创建一个 GPUImageMovieWriter 作为链路的输出,与上面的拍照接口类似,这里录制的视频不一定和我们的预览一样。

    整个过程比较简单,当我们调用停止录制的接口并回调之后,视频就被保存到我们指定的路径了。

    - (void)setupMovieWriter {
        NSString *videoPath = [SCFileHelper randomFilePathInTmpWithSuffix:@".m4v"];
        NSURL *videoURL = [NSURL fileURLWithPath:videoPath];
        CGSize videoSize = self.videoSize;
    
        self.movieWriter = [[GPUImageMovieWriter alloc] initWithMovieURL:videoURL
                                                                    size:videoSize];
    
        GPUImageFilter *lastFilter = self.currentFilterHandler.lastFilter;
        [lastFilter addTarget:self.movieWriter];
        self.camera.audioEncodingTarget = self.movieWriter;
        self.movieWriter.shouldPassthroughAudio = YES;
    
        self.currentTmpVideoPath = videoPath;
    }


    - (void)recordVideo {
        [self setupMovieWriter];
        [self.movieWriter startRecording];
    }


    - (void)stopRecordVideoWithCompletion:(RecordVideoResult)completion {
        @weakify(self);
        [self.movieWriter finishRecordingWithCompletionHandler:^{
            @strongify(self);
            [self removeMovieWriter];
            if (completion) {
                completion(self.currentTmpVideoPath);
            }
        }];
    }


    2、多段录制

    在 GPUImage 中并没有提供多段录制的功能,需要我们自己去实现。

    首先,我们要重复单段视频的录制过程,这样我们就有了多段视频的文件路径。然后主要实现两个功能,一个是 AVPlayer 的多段视频循环播放;另一个是通过 AVComposition 来合并多段视频,并用 AVAssetExportSession 来导出新的视频。

    整个过程逻辑并不复杂,出于篇幅的考虑,代码就不贴了,请到项目中查看。

    三、保存

    在拍照或者录视频结束后,通过 PhotoKit 保存到相册里。

    1、保存图片

    - (void)writeImageToSavedPhotosAlbum:(UIImage *)image
                              completion:(void (^)(BOOL success))completion {
        [[PHPhotoLibrary sharedPhotoLibrary] performChanges:^{
            [PHAssetChangeRequest creationRequestForAssetFromImage:image];
        } completionHandler:^(BOOL success, NSError * _Nullable error) {
            if (completion) {
                completion(success);
            }
        }];
    }


    2、保存视频

    - (void)saveVideo:(NSString *)path completion:(void (^)(BOOL success))completion {
        NSURL *url = [NSURL fileURLWithPath:path];
        [[PHPhotoLibrary sharedPhotoLibrary] performChanges:^{
            [PHAssetChangeRequest creationRequestForAssetFromVideoAtFileURL:url];
        } completionHandler:^(BOOL success, NSError * _Nullable error) {
            dispatch_async(dispatch_get_main_queue(), ^{
                if (completion) {
                    completion(success);
                }
            });
        }];
    }


    四、闪光灯

    系统的闪光灯类型通过 AVCaptureDevice 的 flashMode 属性来控制,其实只有三种,分别是:

    • AVCaptureFlashModeOff 关闭
    • AVCaptureFlashModeOn 开启(在拍照的时候会闪一下)
    • AVCaptureFlashModeAuto 自动(系统会自动判断当前的环境是否需要闪光灯)

    但是市面上的相机应用,一般还有一种常亮类型,这种类型在夜间的时候会比较适用。这个功能需要通过 torchMode 属性来实现,它其实是指手电筒。

    我们对这个两个属性做一下封装,允许这四种类型来回切换,下面是根据封装的类型来同步系统类型的代码:

    - (void)syncFlashState {
        AVCaptureDevice *device = self.camera.inputCamera;
        if (![device hasFlash] || self.camera.cameraPosition == AVCaptureDevicePositionFront) {
            [self closeFlashIfNeed];
            return;
        }
    
        [device lockForConfiguration:nil];
    
        switch (self.flashMode) {
            case SCCameraFlashModeOff:
                device.torchMode = AVCaptureTorchModeOff;
                device.flashMode = AVCaptureFlashModeOff;
                break;
            case SCCameraFlashModeOn:
                device.torchMode = AVCaptureTorchModeOff;
                device.flashMode = AVCaptureFlashModeOn;
                break;
            case SCCameraFlashModeAuto:
                device.torchMode = AVCaptureTorchModeOff;
                device.flashMode = AVCaptureFlashModeAuto;
                break;
            case SCCameraFlashModeTorch:
                device.torchMode = AVCaptureTorchModeOn;
                device.flashMode = AVCaptureFlashModeOff;
                break;
            default:
                break;
        }
    
        [device unlockForConfiguration];
    }


    五、画幅比例

    相机的比例通过设置 AVCaptureSession 的 sessionPreset 属性来实现。这个属性并不只意味着比例,也意味着分辨率。

    由于不是所有的设备都支持高分辨率,所以这里只使用 AVCaptureSessionPreset640x480 和 AVCaptureSessionPreset1280x720 这两个分辨率,分别用来作为 3:4 和 9:16 的输出。

    市面上的相机除了上面的两个比例外,一般还支持 1:1 和 Full (iPhoneX 系列的全屏)比例,但是系统并没有提供对应比例的 AVCaptureSessionPreset 。

    这里可以通过 GPUImageCropFilter 来实现,这是 GPUImage 的一个内置滤镜,可以对输入的纹理进行裁剪。使用时通过 cropRegion 属性来传入一个归一化的裁剪区域。

    切换比例的关键代码如下:

    - (void)setRatio:(SCCameraRatio)ratio {
        _ratio = ratio;
    
        CGRect rect = CGRectMake(0, 0, 1, 1);
        if (ratio == SCCameraRatio1v1) {
            self.camera.captureSessionPreset = AVCaptureSessionPreset640x480;
            CGFloat space = (4 - 3) / 4.0; // 竖直方向应该裁剪掉的空间
            rect = CGRectMake(0, space / 2, 1, 1 - space);
        } else if (ratio == SCCameraRatio4v3) {
            self.camera.captureSessionPreset = AVCaptureSessionPreset640x480;
        } else if (ratio == SCCameraRatio16v9) {
            self.camera.captureSessionPreset = AVCaptureSessionPreset1280x720;
        } else if (ratio == SCCameraRatioFull) {
            self.camera.captureSessionPreset = AVCaptureSessionPreset1280x720;
            CGFloat currentRatio = SCREEN_HEIGHT / SCREEN_WIDTH;
            if (currentRatio > 16.0 / 9.0) { // 需要在水平方向裁剪
                CGFloat resultWidth = 16.0 / currentRatio;
                CGFloat space = (9.0 - resultWidth) / 9.0;
                rect = CGRectMake(space / 2, 0, 1 - space, 1);
            } else { // 需要在竖直方向裁剪
                CGFloat resultHeight = 9.0 * currentRatio;
                CGFloat space = (16.0 - resultHeight) / 16.0;
                rect = CGRectMake(0, space / 2, 1, 1 - space);
            }
        }
        [self.currentFilterHandler setCropRect:rect];
        self.videoSize = [self videoSizeWithRatio:ratio];
    }


    六、前后置切换

    通过调用 GPUImageVideoCamera 的 rotateCamera 方法来实现。

    另外,由于前置摄像头不支持闪光灯,如果在前置的时候去切换闪光灯,只能修改我们封装的类型。所以在切换到后置的时候,需要去同步一下系统的闪光灯类型:

    - (void)rotateCamera {
        [self.camera rotateCamera];
        // 切换摄像头,同步一下闪光灯
        [self syncFlashState];
    }


    七、对焦

    AVCaptureDevice 的 focusMode 用来设置聚焦模式,focusPointOfInterest 用来设置聚焦点;exposureMode 用来设置曝光模式,exposurePointOfInterest 用来设置曝光点。

    前置摄像头只支持设置曝光,后置摄像头支持设置曝光和聚焦,所以在设置之前要先判断是否支持。

    需要注意的是,相机默认输出的图像是横向的,图像向右偏转。而前置摄像头又是镜像,所以图像是向左偏转。我们从 UIView 获得的触摸点,要经过相应的转化,才是正确的坐标。关键代码如下:

    - (void)setFocusPoint:(CGPoint)focusPoint {
        _focusPoint = focusPoint;
    
        AVCaptureDevice *device = self.camera.inputCamera;
    
        // 坐标转换
        CGPoint currentPoint = CGPointMake(focusPoint.y / self.outputView.bounds.size.height, 1 - focusPoint.x / self.outputView.bounds.size.width);
        if (self.camera.cameraPosition == AVCaptureDevicePositionFront) {
            currentPoint = CGPointMake(currentPoint.x, 1 - currentPoint.y);
        }
    
        [device lockForConfiguration:nil];
    
        if ([device isFocusPointOfInterestSupported] &&
            [device isFocusModeSupported:AVCaptureFocusModeAutoFocus]) {
            [device setFocusPointOfInterest:currentPoint];
            [device setFocusMode:AVCaptureFocusModeAutoFocus];
        }
        if ([device isExposurePointOfInterestSupported] &&
            [device isExposureModeSupported:AVCaptureExposureModeAutoExpose]) {
            [device setExposurePointOfInterest:currentPoint];
            [device setExposureMode:AVCaptureExposureModeAutoExpose];
        }
    
        [device unlockForConfiguration];
    }


    八、改变焦距

    改变焦距简单来说就是画面的放大缩小,通过设置 AVCaptureDevice 的 videoZoomFactor 属性实现。

    值得注意的是,这个属性有最大值和最小值,设置之前需要做好判断,否则会直接崩溃。代码如下:

    - (void)setVideoScale:(CGFloat)videoScale {
        _videoScale = videoScale;
    
        videoScale = [self availableVideoScaleWithScale:videoScale];
    
        AVCaptureDevice *device = self.camera.inputCamera;
        [device lockForConfiguration:nil];
        device.videoZoomFactor = videoScale;
        [device unlockForConfiguration];
    }


    - (CGFloat)availableVideoScaleWithScale:(CGFloat)scale {
        AVCaptureDevice *device = self.camera.inputCamera;
    
        CGFloat maxScale = kMaxVideoScale;
        CGFloat minScale = kMinVideoScale;
        if (@available(iOS 11.0, *)) {
            maxScale = device.maxAvailableVideoZoomFactor;
        }
    
        scale = MAX(scale, minScale);
        scale = MIN(scale, maxScale);
    
        return scale;
    }


    九、滤镜

    1、滤镜的使用

    当我们想使用一个滤镜的时候,只需要把它加到滤镜链里去,通过 addTarget: 方法实现。来看一下这个方法的定义:

    - (void)addTarget:(id<GPUImageInput>)newTarget;


    可以看到,只要实现了 GPUImageInput 协议,就可以成为滤镜链的下一个结点。

    2、美颜滤镜

    目前美颜效果已经成为相机应用的标配,我们也来给自己的相机加上美颜的效果。

    美颜效果本质上是对图片做模糊,想要达到比较好的效果,需要结合人脸识别,只对人脸的部分进行模糊处理。这里并不去探究美颜算法的实现,直接找开源的美颜滤镜来用。

    目前找到的实现效果比较好的是 LFGPUImageBeautyFilter ,虽然它的效果肯定比不上现在市面上的美颜类 APP,但是作为学习级别的 Demo 已经足够了。

    效果展示:

    [图片上传失败…(image-173148-1610618344596)]

    <figcaption style=”box-sizing: border-box; display: block;”></figcaption>

    3、自定义滤镜

    打开 GPUImageFilter 的头文件,可以看到有下面这个方法:

    - (id)initWithVertexShaderFromString:(NSString *)vertexShaderString 
                fragmentShaderFromString:(NSString *)fragmentShaderString;


    很容易理解,通过一个顶点着色器和一个片段着色器来初始化,并且可以看到是字符串类型。

    另外,GPUImageFilter 中还内置了简单的顶点着色器和片段着色器,顶点着色器代码如下:

    NSString *const kGPUImageVertexShaderString = SHADER_STRING
    (
     attribute vec4 position;
     attribute vec4 inputTextureCoordinate;
    
     varying vec2 textureCoordinate;
    
     void main()
     {
         gl_Position = position;
         textureCoordinate = inputTextureCoordinate.xy;
     }
    );


    这里用到了 SHADER_STRING 宏,看一下它的定义:

    #define STRINGIZE(x) #x
    #define STRINGIZE2(x) STRINGIZE(x)
    #define SHADER_STRING(text) @ STRINGIZE2(text)


    在 #define 中的 # 是「字符串化」的意思,返回 C 语言风格字符串,而 SHADER_STRING 在字符串前面加了一个 @ 符号,则 SHADER_STRING 的定义就是将括号中的内容转化为 OC 风格的字符串。

    我们之前都是为着色器代码单独创建两个文件,而在 GPUImageFilter 中直接以字符串的形式,写死在代码中,两种方式本质上没什么区别。

    当我们想自定义一个滤镜的时候,只需要继承 GPUImageFilter 来定义一个子类,然后用相同的方式来定义两个保存着色器代码的字符串,并且用这两个字符串来初始化子类就可以了。

    作为示例,我把之前实现的 抖音滤镜 也添加到这个工程里,来看一下效果:

    [图片上传失败…(image-28bd40-1610618344595)]

    <figcaption style=”box-sizing: border-box; display: block;”></figcaption>

    总结

    通过上面的步骤,我们实现了一个具备基础功能的相机。之后会在这个相机的基础上,继续做一些有趣的尝试,欢迎持续关注~

    源码

    请到 GitHub 上查看完整代码。

    参考

    获取更佳的阅读体验,请访问原文地址【Lyman’s Blog】使用 GPUImage 实现一个简单相机
  • wp-autopost-pro数据采集器爬虫工具WORDPRESS插件下载

    wp-autopost-pro数据采集器爬虫工具WORDPRESS插件下载

    WordPress目前最新版本已经到了WP 5.3.2 , 我第一时间尝试了,然后也更新了本采集插件,亲自测试,目前完美运行于最新的版本,请放心使用。WP-AutoPost-Pro 是一款优秀的 WordPress 文章采集器,是您操作站群,让网站自动更新内容的利器!如果是新手,请查看采集教程:http://wp-autopost.net/zh/manual/

    网盘包含wp-autopost-pro 3.6.2、wp-autopost-pro 3.7.8版本

    采集插件适用对象

    • 1、刚建的wordpress站点内容比较少,希望尽快有比较丰富的内容;
    • 2、热点内容自动采集并自动发布;
    • 3、定时采集,手动采集发布或保存到草稿;
    • 4、css样式规则,能更精确的采集需要的内容。
    • 5、伪原创与翻译、代理IP进行采集、保存Cookie记录;
    • 6、可采集内容到自定义栏目
    • 7、解决部分用户使用3.6.1版本导致整站后台与前台卡顿的问题!
    • —-此版本与官方的功能没有任何区别;

    WP-AutoPost Pro 在采集方面有什么优势?

    一、安装方便,全自动采集,实现无人值守

    WP-AutoPost 可以直接在后台插件面板上传安装,只需要点击几下,就可以激活使用。激活后,你可以看到 WP-AutoPost 的管理面板被集成在了左侧,各种采集规则设置一目了然,即便是 WordPress 新手也能很快上手。等到配置完采集规则后,即可以开启任务,WP-AutoPost 会自动采集好目标站的内容,自动发布到你的网站里。

    二、采集规则配置简单,支持通配符和 CSS,完美支持 WordPress 各种功能

    相比于火车头采集器的繁琐规则,WP-AutoPost Pro 真正做到了人性化,它的定向采集只需要提供文章列表 URL 即可智能采集来自于任何网站或栏目的内容。支持采集标题,正文,可自动设置分类目录、标签、摘要、特色图片,支持自定义栏目、自定义文章类型等。

    三、中英文翻译,伪原创的支持

    相信很多站长有伪原创这方面的需求,来迎合搜索引擎的喜好。WP-AutoPost Pro 巧妙的内置了各种伪原创工具,支持百度翻译(需要配置接口),也支持国外最优秀伪原创工具 WordAi,Spin Rewriter 等。
    四、支持图片等附件下载,支持添加水印,支持 Flick、七牛云等第三方图片存储

    WP-AutoPost Pro 还有个令人称赞的地方是支持远程图片下载到本地服务器,也可以下载到像 Flick、七牛云等第三方图片存储,并且可以为图片加上水印(文本水印和图片水印)。

    五、强大的 SEO 设置选项

    像火车头一样,WP-AutoPost 采集插件也支持 HTML 标签过滤,关键词替换,自动添加链接,添加自定义内容,自定义文章样式等,最大限度得使采集的内容区别于原网站的内容,利于搜索引擎排名。

    附加:

    WP-AutoPost Pro V3.6.2版本

    特别说明:

    • 1. 本插件是基于 WP-AutoPost Pro对应版本破解修复版,耗费了店主的大量时间与精力。
    • 2.本版本主要修复了:规则正确后采集找不到文章内容和标题(采集整版二次验证问题),翻译功能无法使用的问题。
    • 3.不要说买完用不了(不提供技术支持,插件官网有教程),建议有基础知识的朋友购买。

    下面wp-autopost-pro采集测试

  • CGI 月球套件

    CGI 月球套件

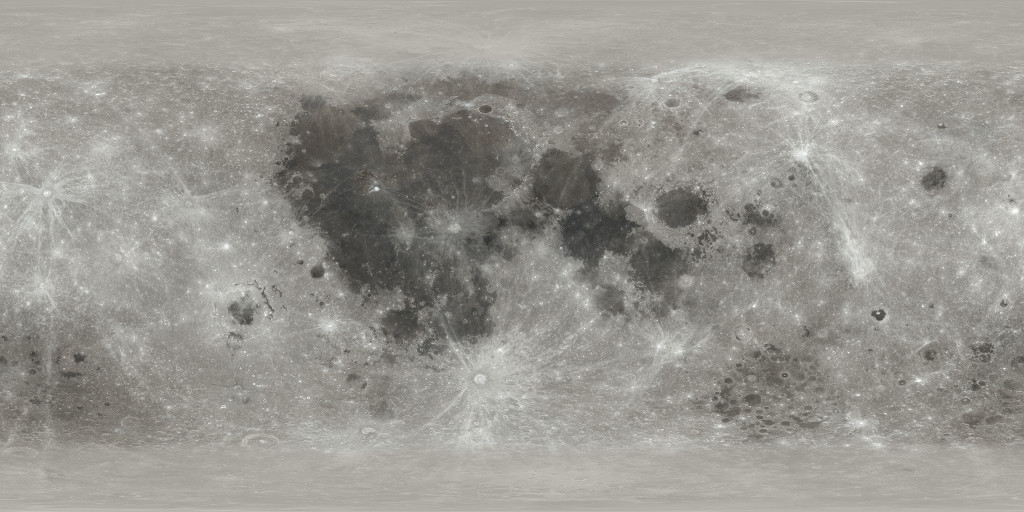
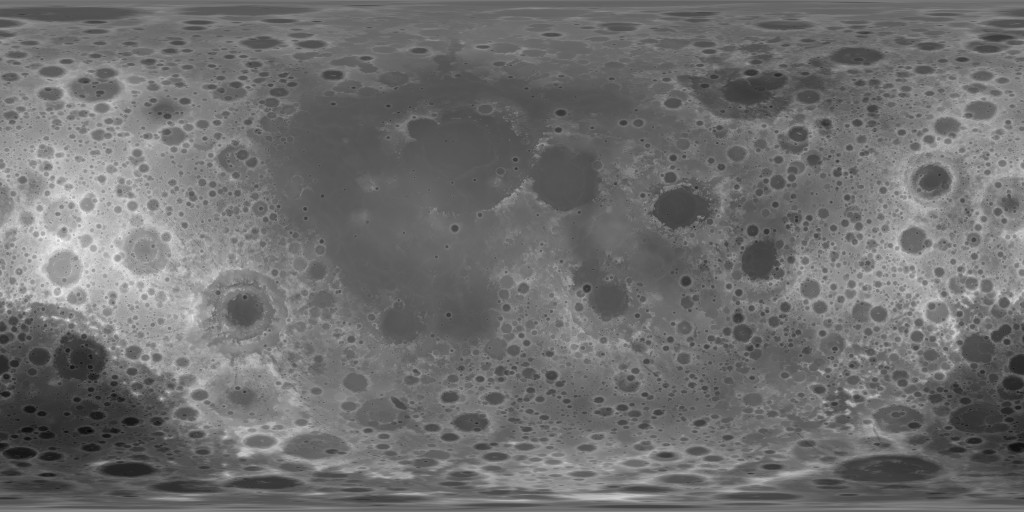
    这些颜色和高程图专为在 3D 渲染软件中使用而设计。它们是由月球勘测轨道器相机和激光高度计仪器团队收集的数据创建的。

    颜色

    下载选项颜色图,以各种大小的 24 位 RGB TIFF 形式提供。进入:https://svs.gsfc.nasa.gov/4720?ref=producthunt

    地图以 0° 经度为中心。彩色地图改编自Hapke Normalized WAC Mosaic,这是相机团队根据超过 100,000 张 WAC(广角相机)图像构建的合成图。自述文件提供了有关如何构建马赛克的技术摘要以及对更详细出版物的参考。在这篇 LROC 博客文章和这篇文章中对这个过程进行了不太正式的介绍。

    对于此处的颜色图,可视化器修改并组合了 LROC 颜色数据的七个波段中的三个,以更接近人眼所见。红色通道包含 643 nm 波段,而绿色和蓝色是由 566 和 415 nm 波段的不同线性组合创建的,以更接近将它们集中在 532 nm(绿色)和 472 nm(蓝色)上。应用了 2.8 的 gamma(LROC 数据是线性的),通道乘以 (0.935, 1.005, 1.04) 以平衡颜色。强度范围 (0.16, 0.4) 映射到每个通道的完整 (0, 255) 8 位范围。使用 Photoshop 的内容感知点修复画笔修复顶部和底部附近的小数据丢失。

    源数据涵盖了从 70°N 到 70°S 的月球地球。因为月球的轴向和轨道倾角都很小,这些纬度以外的许多区域仍然笼罩在阴影中,即使经过 LRO 的相机数千次后,它们也被排除在 LROC 马赛克之外。对于这张彩色地图,缺失的纬度由 LRO 激光高度计的单色 LROC 数据和反照率图 ( LDAM ) 组合而成。当使用逼真的阴影渲染时,地图的这些部分并不是特别明显,虽然它们占地图像素的 20% 以上,但它们仅代表月球表面的 6%。

    此图像针对美学而非科学进行了优化。科学应用应该使用源数据。

    移位

    下载选项置换贴图,每度 64、16 和 4 个像素,以 0° 经度为中心。可用作以公里为单位的浮点 TIFF,相对于 1737.4 公里的半径,或以半米为单位的无符号 16 位 TIFF,相对于 1727400 米的半径。位移图(也称为高度图或高程图)直接取自月球轨道器激光高度计仪器团队的最新(截至 2019 年春季)网格化数据产品。LOLA 数据存档在行星数据系统的地球科学节点上。存储在那里的 LOLA 数据的一小部分,即每度 4、16 和 64 像素的全局圆柱投影,已在此处重新格式化为未压缩的 TIFF 文件,垂直单位为浮点千米或 16 位无符号整数半-米。
    所有 LRO 数据的参考表面是一个半径为 1737.4 公里的球体。LOLA 的网格高程数据以相对于该半径的半米为单位以带符号的 16 位整数形式发布。对于浮点 TIFF,源数据除以 2000。对于无符号 16 位 TIFF,源数据偏移了 +20,000(10 公里),因此所有值都是正数。后一种格式是为不能很好地处理浮点或有符号整数文件的软件提供的。

    如何使用这些地图

    这些纹理图中的每个像素对应于由经纬度对定义的月球表面上的一个点。颜色图中的像素包含基色在应用不同的光和摄像机角度(在技​​术描述中称为入射角i和发射角e )的影响之前,表面的表面。置换贴图中的像素包含相应位置的表面高度。

    更多数据

    这些地图是LRO 仪器团队公开存档的数据的一小部分。所有数据都采用标准且相当简单的 PDS 文件格式(带有.IMG文件扩展名的文件)。尽管通用计算机图形软件通常不支持这些格式,但某些 GIS 程序可以直接读取这些格式。数据格式记录在 PDS 标签中,这些标签可以是带有.LBL文件扩展名的单独文本文件,也可以是作为固定长度标题嵌入的文件。除了可能的标头之外,大多数 .IMG 文件都是未压缩的二维二进制数字数组。一些数据也以 TIFF 或 JPEG2000 格式提供。

    在撰写本文时,月球赤道和中纬度地区的最佳全球尺度高程数据(分辨率高达 512 像素/度)是SLDEM2015。对于靠近两极的区域,激光射击的密度要高得多,极地立体投影中的 GDR 数据达到每像素 5 米的分辨率。

    LROC 窄角相机 (NAC) 以每像素一米或更高的分辨率对月球表面的大部分区域进行了成像。可以使用其Quickmap界面以图形方式探索 LROC 图像,并在其RDR 产品选择上进行搜索页。特别令人感兴趣的是地形产品(页面左上角的菜单选项),它与从立体图像对派生的高分辨率 DEM 相匹配。该数据集包括所有阿波罗登陆点和数十个其他感兴趣的位置。

  • 手机号码归属地查询api [开源]

    手机号码归属地查询api [开源]

    手机号码归属地查询api 同时返回省,市,运营商,邮编,区号,行政代码. 采用JsonDB 1.0数据库驱动,进行分表处理,速度超快,同时辅助文件缓存,对于同请求进行缓存处理.大大提交了效率 数据来源于网络,如有问题可联系我修改,我会定期进行修改.

    本数据库收录数据包含新增加的14 16 17 18 19号段号码. 压缩后数据库大小:2M左右

    20190216 收录419454 条数据,大小:1.99M

    20190110 收录419385 条数据,大小:1.99M

    20190104 收录419054 条数据,大小:1.98M

    20190103 收录417183 条数据,大小:1.98M

    20181225 收录416859 条数据,大小:1.79M

    20181224 收录416894 条数据,大小:1.6M

    20181220 收录381199条数据,大小:1.47M

    软件架构
    纯php语言加JsonDB 1.0数据库驱动,进行按号段分表处理,实现秒查

    免费API调用:http://tool.bitefu.net/shouji/?mobile=手机号

    支持jsonp https调用
    ————————————————
    开源地址:https://gitee.com/web/mobileLocation

    http://tool.bitefu.net/shouji/?mobile=15989520725

  • 宝塔搭建NeteaseCloudMusicApi

    宝塔搭建NeteaseCloudMusicApi

    https://github.com/nondanee/NeteaseCloudMusicApi

    关于NeteaseCloudMusicApi就不多说了,放点官方介绍把!

    https://binaryify.github.io/NeteaseCloudMusicApi
    1:安装Npm

    因为之前有个旧版本的Npm所以就先卸载了把

    yum remove nodejs npm -y

    卸载后开始安装

    yum install npm - y

    2:安装nodejs最新版本

    npm install -g nn latest

    安装后可以输入n切换版本

    node -v

    注释:此处可以在宝塔的PM2管理器中进行切换版本

    3:安装NeteaseCloudMusicApi
    git clone git@github.com:Binaryify/NeteaseCloudMusicApi.git
    cd NeteaseCloudMusicApi
    npm install
    
    在宝塔【软件商店】中查找 PM2管理器并安装,进入管理页面,在项目列表选项卡下添加【项目所在根目录】(上传解压的程序包路径)、【启动文件名称】(js)、【项目名称】(自定义),然后点击添加按钮即可。注意放行 3000 端口,否则程序无法访问。
    
    
    然后再运行安装
    npm install
    这就安装好了,开始跑起来
    
    node app.js
    

    运行地址:

    ip:3000