站长评测:把大淘客、京推推还有拼多多聚合到一起了,可以看演示站!
基于PHP开发一款淘宝客商城系统源码,是一款淘宝客京东拼多多三合一公众号系统,包含了公众号微信端、H5端和封装APP 。本程序完整,包括常用素材文件 常用图片文件,总之非常全面。

资源下载地址:百度盘https://pan.baidu.com/share/init?surl=GQDUsuPtT6hYZJlX6ZTdCw
文件下载密码:4k23
资源演示地址:http://tao.uuhuo.cn/
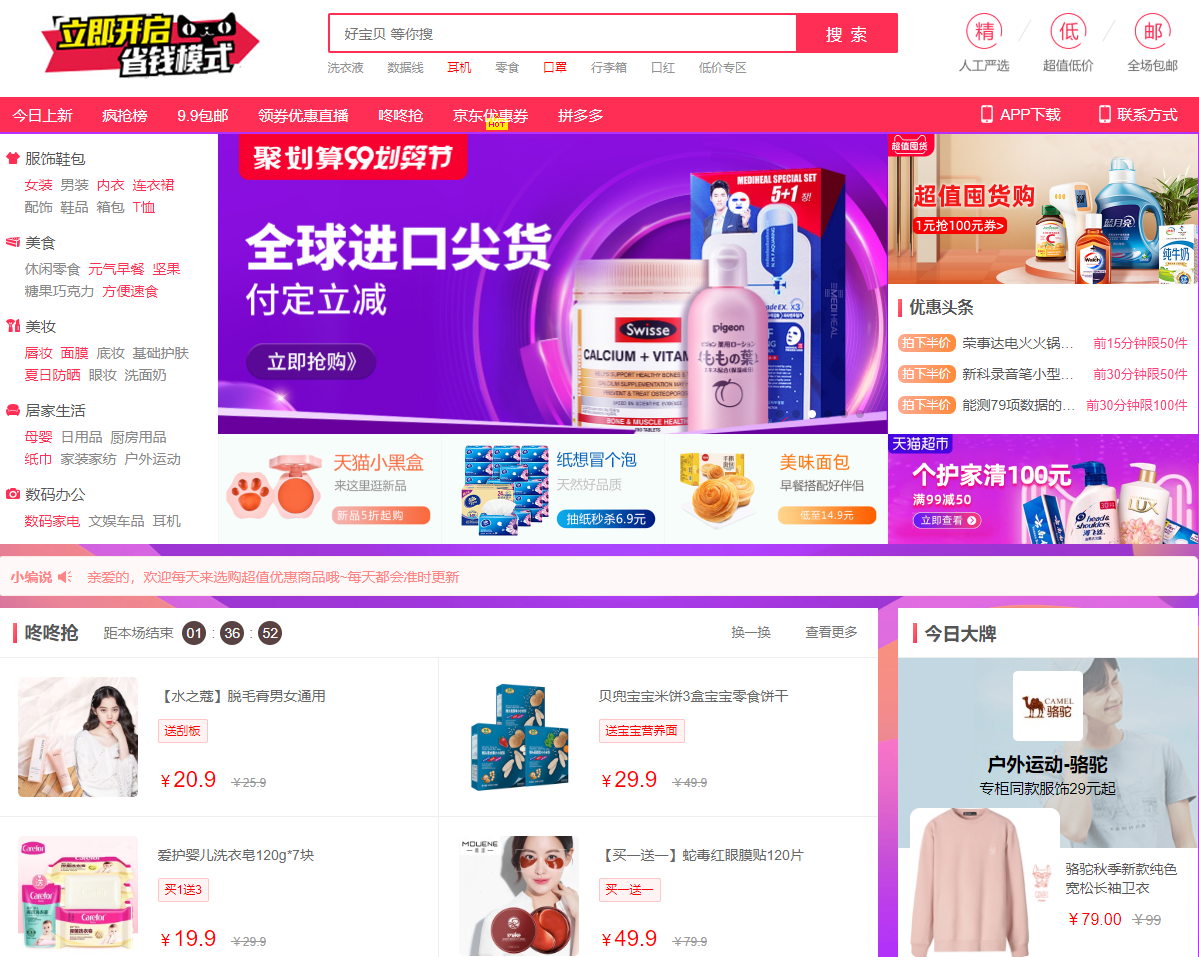
站长评测:把大淘客、京推推还有拼多多聚合到一起了,可以看演示站!
基于PHP开发一款淘宝客商城系统源码,是一款淘宝客京东拼多多三合一公众号系统,包含了公众号微信端、H5端和封装APP 。本程序完整,包括常用素材文件 常用图片文件,总之非常全面。
资源下载地址:百度盘https://pan.baidu.com/share/init?surl=GQDUsuPtT6hYZJlX6ZTdCw
文件下载密码:4k23
资源演示地址:http://tao.uuhuo.cn/
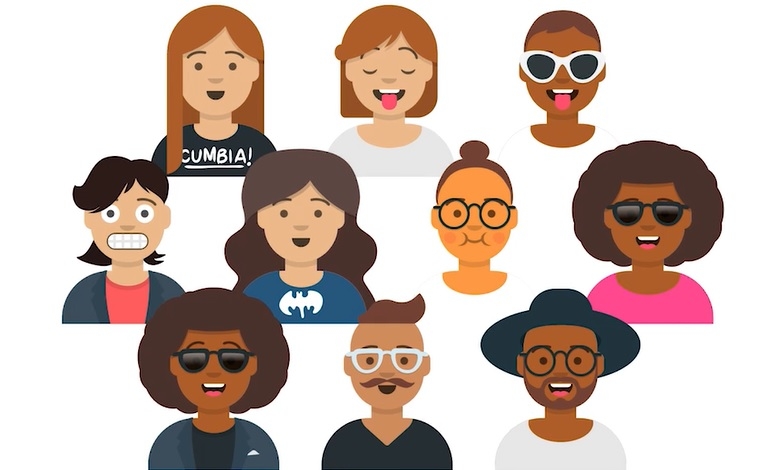
Avataaars generator是一个网页版的免费在线卡通头像生成器,可以自定义参数,生成自己独特风格的头像。这些头像可以是PNG或SVG格式的图片,也可以是一段React代码。

Avataaars就是Avatar,表示头像、阿凡达的意思。
这个网页版卡通头像生成器的开发者是一位1991年出生的帅气小伙,叫林芳本,他是在Sketch库Avataaars的基础上开发的。林芳本曾经也是一位创业者,现在是旧金山湾区公司Niantic的一名软件工程师。Niantic就是那个与任天堂共同发布了AR游戏精灵宝可梦 Go(Pokemon Go)的公司。

最初完成这些头像设计的,是一位叫做Pablo Stanley的哥们,他有着多年设计经验的设计师,现任产品设计平台InVision的设计主管。Pablo Stanley还制作了一个免费的Sketch库,安装后可以在Sketch中方便的创建卡通头像。
资源下载地址:https://github.com/fangpenlin/avataaars-generator
资源演示地址:https://avatarmaker.com/
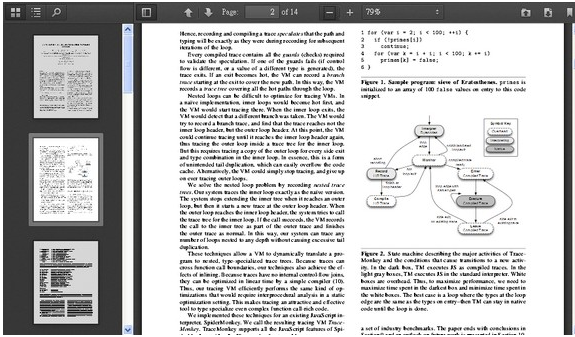
在线PDF浏览

在我百度google好久终于明白原来类似百度文库豆丁网它们是先将PDF等文档转换成SWF文件,然后通过播放器来播放SWF文件来达到在线浏览的效果,而另外有通过jQuery插件的直接在实现。
在开源中国有介绍这8个jQuery的PDF浏览插件,其中有一种是PDF.js的是一个技术原型主要用于在HTML5平台上展示PDF文档,无需任何本地技术支持。今天介绍的wordpress在线PDF插件有一款就是通过这个PDF.js实现的。
PDF.JS在线演示:http://mozilla.github.io/pdf.js/web/viewer.html
PDF.JS开源地址:https://github.com/mozilla/pdf.js
而其他有没有实现在线PDF文档浏览的具体可行方法呢?其实是有很多的,不过不好实现,如果你需要的话以下是一些参考。希望对你有帮助。
有没有开源的,可以直接浏览 pdf 的网站程序?
pdf2swf+flexpaper解决pdf在线阅读(类百度文库)
Office Web App2013 在线查看PDF文件
wordpress在线PDF插件
对于用wordpress的站点来说似乎有更简单的方法,那就是自己不动手用别人的插件,这也许是大多数人都能实现的方法了,今天介绍的wordpress在线PDF插件分别是PDF.js Viewer Shortcode和Prizm Viewer插件。
PDFjsViewer
这插件就像艾尔云上面说的是通过PDF.js来实现的,对于不支持HTML5的浏览器来说似乎是没戏,不过HTML5迟早是趋势。用起来界面美观大方。
PDF.jsViewerShortcode主页:https://wordpress.org/plugins/pdfjs-viewer-shortcode/
使用方法其实很简单,后台安装启用之后,在写文章的时候插入短代码来实现的,如果你了解wordpress的话可以直接集成到wordpress后台编辑器中使用起来直接点击按钮加入链接即可。
短代码:[pdfjs-viewer url=http://www.aaa.com/test.pdf viewer_width=600px viewer_height=700px fullscreen=true download=true print=true openfile=false]
url (必填项):直接链接直接PDF文件
viewer_width(可选):宽度(默认值:100%)
viewer_height(可选):高度(默认值:1360px)
fullscreen(可选):true/false,上面显示全屏浏览器链接(默认:真)
download(可选):true/false,启用或禁用下载按钮(默认:真)
print (可选):true/false,启用或禁用打印按钮(默认:真)
openfile(可选):true/false,可启用或禁用打开文件按钮,(缺省值:false)
如果你懂点HTML的话里面的选项都不太难理解,自己设置即可。
PrizmViewer
Prizm Viewer插件是一款强大的文档阅读器,Prizm实际上是一个云服务提供商,提供文档,图像的存储(有点像Google Docs)。而Prizm Viewer插件就是该提供商开发的一款插件,允许WordPress博主在网站中加入文档在线预览功能,支持DOC,XLS,PPT,PDF,CAD等近300种格式。
插件主页:https://wordpress.org/plugins/prizm-cloud-document-viewer/
听起来不错可就是用起来麻烦点儿,需要注册并且选用Prizm的免费套餐,然后经过一系列的设置来实现网站在先PDF阅读的目的,好吧说了这么多,到底怎么用呢?表急!艾尔云给出参考地址。
Prizm Viewer插件——为你的WordPress加入文档阅读器(支持DOC,XLS,PPT,PDF,CAD等多种格式)
本文小结
经过上面一番折腾算是可以在线PDF浏览了,一些网站程序除了用现成的插件之外。目前实现在线PDF浏览而且防止复制的主要有两种方法,一种就是通过工具将上传的PDF等文档转换成SWf文件然后再播放类似豆丁网百度文库,另外一种就是office web app这是微软出品,网易邮箱在线PDF浏览似乎是这个。
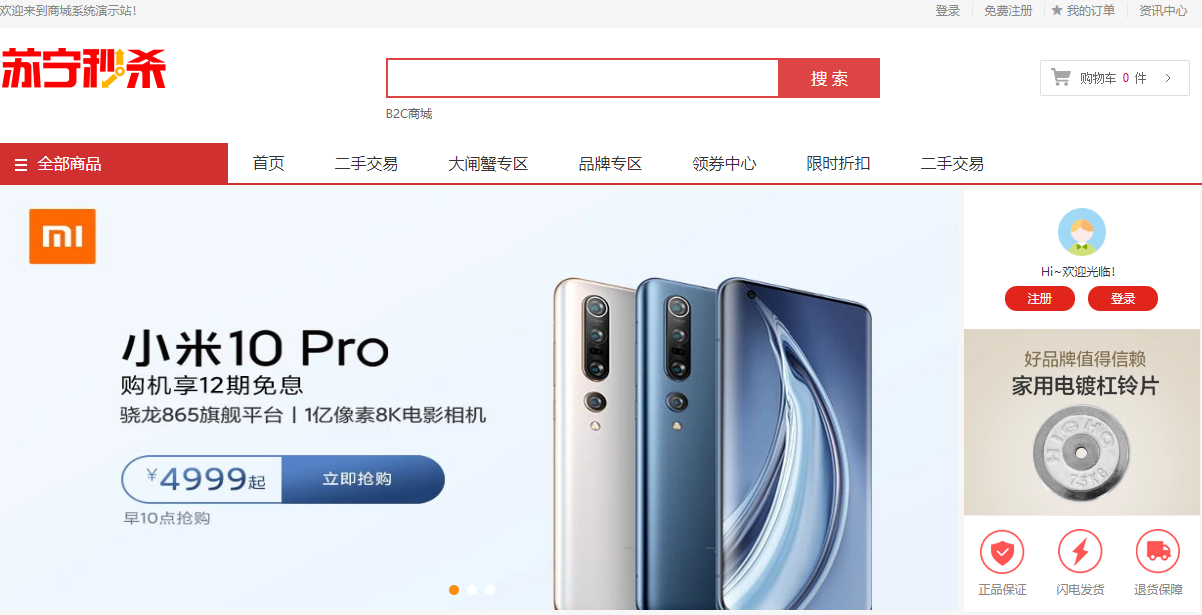
这是一个B2C的商城系统,功能完整,没有任何缺失,安装就可以直接使用,希望在大家的共同努力下,让这个系统覆盖到到小程序端。
更新到了1.1.1版本,支持微信,支付宝支付及实时退款。
B2C商城源码
功能如下:
1、 支持PC+H5版本(H5版本可以对接公众号进行二次开发)
2、 支持虚拟商品自动发货
3、 支持自定义多种规格参数商品管理
4、 支持拼团活动,自定义商品团购活动,线上营销活动更丰富。
5、 支持限时折扣,自定义折扣比例,多种营销活动助力线上运营
6、 支持优惠券,自定义优惠券可使用商品范围。
7、 支持会员积分,积分可以抵扣购物金额。
8、 支持品牌管理,查找商品时按品牌分类检索
9、 支持APP套壳,免费打包自己的专属APP,做到全平台覆盖
10、 支持webview形式的小程序,现在小程序支持webview形式了,可以直接做成小程序。
11、 支持支付宝,微信支付,网银支付,余额支付等多种支付方式(仅需简单配置)
12、 支持订单管理,可直接查看各种状态的订单(待付款,待发货,已发货,交易完成,交易关闭)
13、 支持退款/退货管理,退货管理清晰明了,不用再海量订单中查找订单。
14、 支持打印发货单和快递单,方便订单到物流的管理。
15、 资金列表,可以查看所有资金动帐明细。
16、 支持不同等级会员,不同等级会员享受不同购物折扣比。
17、 支持自定义广告管理
18、 支持线上数据库备份
技术参数
1、 支持伪静态
2、 支持对php7的支持
3、 支持百万级数据库压力测试
4、 经过多重安全漏洞检测
5、 Win或linux都可以安装

注:在手机端打开就自动是H5版本
资源下载地址:http://www.qiye1000.com/talk/?thread-101.htm
资源演示地址:http://test.szkandk.cn/xyshop/
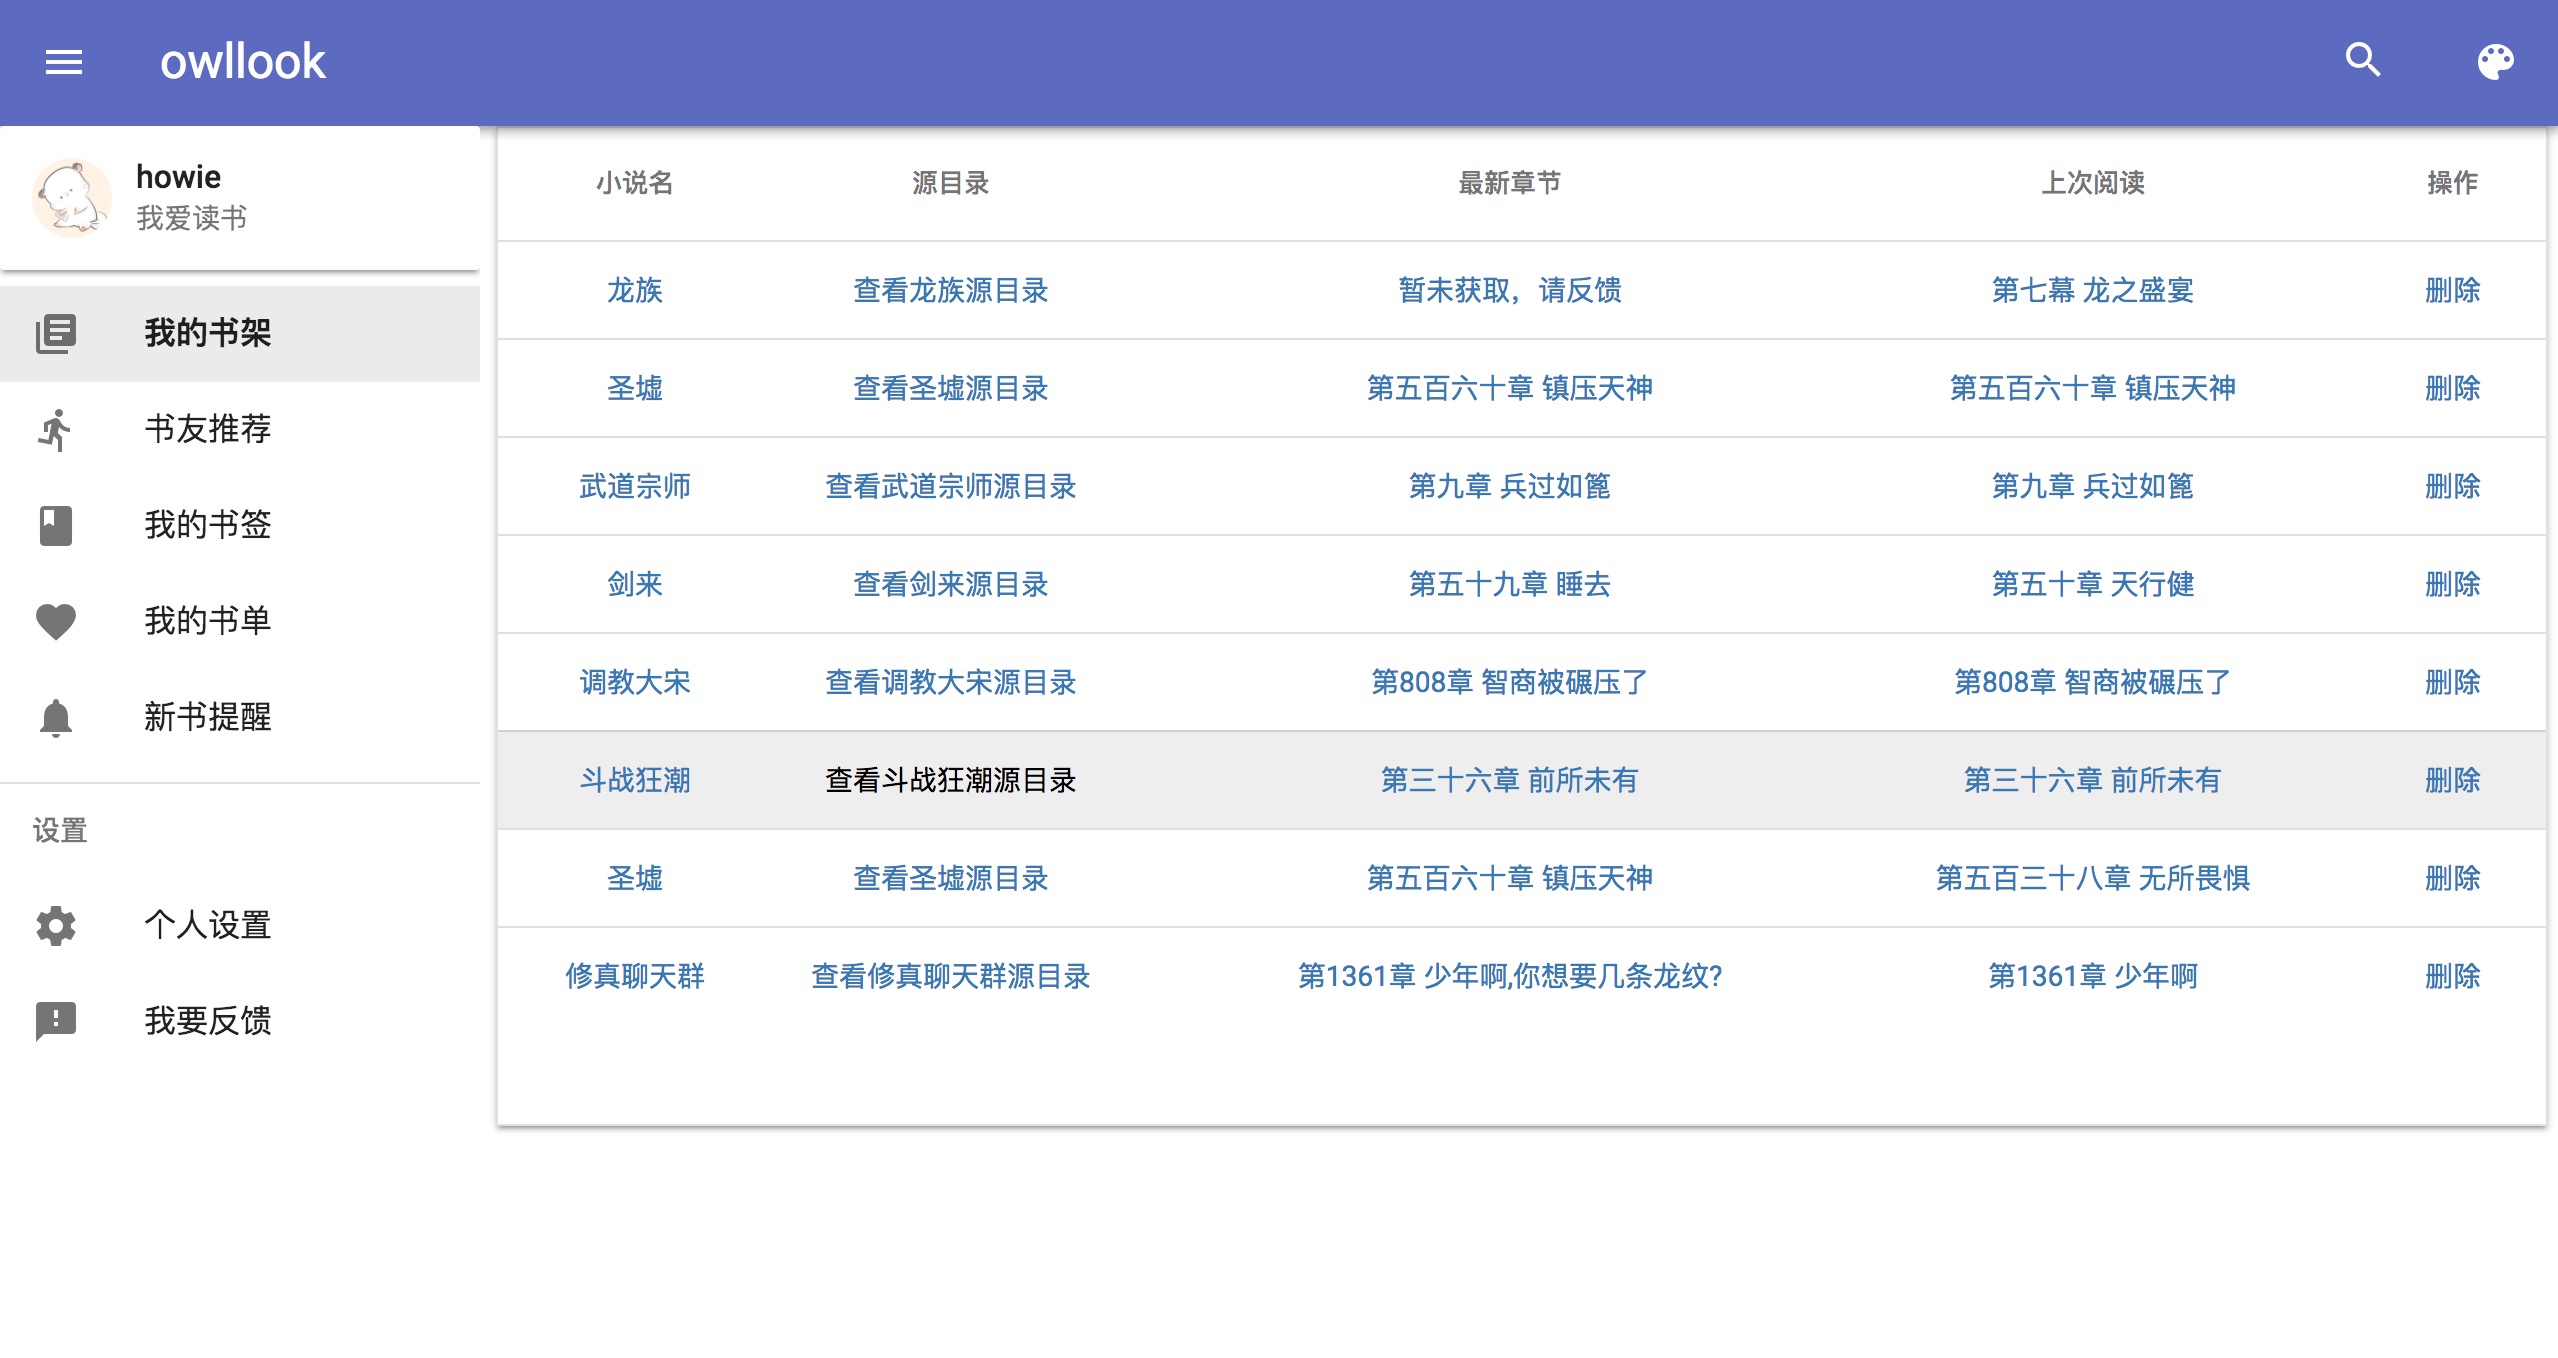
owllook-在线网络小说阅读网站&小说搜索引擎&小说推荐系统[搜索、追书、收藏、追更、小说API]
owllook是一个基于其他搜索引擎构建的垂直小说搜索引擎,owllook目的是让阅读更简单、优雅,让每位读者都有舒适的阅读体验,如搜书、阅读、收藏、追更、推荐等功能.
本站仅收集与分享该项目,不负责技术安装或任何咨询服务!
目前实现功能如下:
注意:若将本项目部署并发行,请声明来源,本项目纯属共享学习之用,不得用于商业!
owllook使用了mongodb储存了用户使用过程中的产生的基本信息,诸如注册信息、搜索小说信息、收藏小说数据等,对于某些必要的缓存,则利用redis进行缓存处理,如小说缓存、session缓存,注意,对于限制数据:都将在24小时删除
对于不同网站的小说,页面规则都不尽相同,我希望能够在代码解析后再统一展示出来,这样方便且美观,而不是仅仅跳转到对应网站就完事,清新简洁的阅读体验才是最重要的
目前采用的是直接在搜索引擎上进行结果检索,我尽量写少量的规则来完成解析,具体见规则定义,遇到自己喜欢的小说网站,你也可以自己添加解析,owllook目前解析了超过 200+ 网站,追更网站解析了50+
有一些地方需要用到爬虫,比如说排行榜,一些书籍信息等,我不想动用重量级爬虫框架来写,于是我在owllook里面编写了一个很轻量的爬虫框架来做这件事,见 ruia
BTW,sanic写界面确实不是很方便,至于为什么写这个,一是想利用sanic尽量做成异步服务,二是想就此练习下推荐系统,顺便作为毕业设计
请先装好mongo以及redis,不会安装mongo看这里,owllook使用pipenv管理虚拟环境,所以使用前请确保安装一个Python3.6环境(比如我这里环境路径在/Users/howie/anaconda3/envs/python36/bin/python3.6),然后安装好pipenv
mongo以及redis装好后,进入项目目录,依照步骤执行:
# 下载代码
git clone https://...
cd owllook
pip install pipenv
# 请先提前创建好Python3.6环境
pipenv install --python /Users/howie/anaconda3/envs/python36/bin/python3.6 --skip-lock
# 进入虚拟环境
pipenv shell

# 先配置好相关数据库配置,具体看`config/dev_config.py`

# 方案一
# 运行:
cd owllook
pipenv run gunicorn -c owllook/config/gunicorn.py --worker-class sanic.worker.GunicornWorker owllook.server:app

# 方案二 推荐
# 安装docker并打包镜像
docker build -t howie6879/owllook .
# 实际运行
docker-compose up -d
# 退出
docker-compose down

[ 详细安装说明请见下一页 ]
首页:

搜索:

榜单:

书架:

目录解析页:

阅读:

为什么首页榜单为空白?
这个是根据小说搜索次数显示的,每天刷新一次,使用多了就会有
为什么会出现302跳转?
为了防止直接运行服务被恶意域名绑定,所以作出如下修改:
vim config/config.py
# 将 true 改为 false
VAL_HOST = os.getenv('VAL_HOST', 'true')
VAL_HOST = os.getenv('VAL_HOST', 'false')
小说榜单页面为什么没有内容?
需要运行owllook/spiders/spider_console.py, 目前代码中是设定60分钟运行一次,运行的时候请酌情更改, os.environ['MODE'] = 'PRO' 这段代码也请注释掉
owllook使用了以下第三方包:
web框架:
owllook is offered under the Apache 2 license.
[ 安装请见下一页 ]